Grand Défi IAgouv du G7
Introduction
Les résultats sont là!
L’intelligence artificielle (IA) offre aux administrations publiques du monde entier l’occasion d’améliorer leur efficacité et les services qu’elles fournissent. Le Grand Défi IAgov du G7 vise à mobiliser les innovateurs et les innovatrices pour relever les défis urgents liés à l’adoption d’une IA pouvant être utilisée de façon responsable au sein du secteur public.
Le Défi est structuré sous forme de laboratoires de solutions rapides (LSR), qui visent à recueillir les solutions proposées par diverses personnes par diverses personnes animées par la même ambition : créer des solutions d’IA évolutives, efficaces et responsables.
Les LSR porte sur quatre problèmes distincts :
1. Les fonctionnaires doivent gérer un nombre considérable de renseignements, souvent manuellement.
Exemple
Un outil comprenant les fonctionnalités suivantes :
- saisie de documents non structurés;
- classification de ces documents;
- détermination des sujets;
- recherche sémantique;
- production de résumés concis et précis.
Exemples de données
-
Données ouvertes : Chambre des communes du Canada (en anglais et français) : données précises sur les délibérations de la Chambre des communes.
-
Notes pour la période des questions (en anglais et français) : trousses de notes pour la période des questions qui sont préparées par une institution fédérale pour les ministres et publiées par le gouvernement du Canada de manière proactive.
-
API de contenu du GOV.UK (en anglais uniquement) : contenu gouvernemental structuré, y compris des directives, des documents d’orientation, des consultations et des publications d’accès à l’information.
-
Centre des développeurs du parlement du Royaume-Uni (en anglais seulement) : ressources pour les développeurs, y compris un répertoire d’API de données ouvertes permettant de partager publiquement les données parlementaires.
-
Docs Italia et Sénat italien (en italien uniquement) : Documentation administrative et actes officiels non réglementaires (par ex., circulaires, notes de politique, motions parlementaires).
-
data.gouv.fr (en français uniquement) : données provenant de la direction de l'information légale et administrative en France.
-
OffenesDatenPortal.de collection de portails municipaux de données ouvertes (en allemand uniquement) : ensembles de données provenant des administrations municipales et des comtés allemands, comprenant des informations sur les processus, les infrastructures et l'utilisation.
-
Plateforme d’information sur les données administratives(en allemand uniquement) : aperçu de l'Office fédéral allemand de la statistique des registres administratifs et des lieux où sont conservées les grandes bases de données administratives.
Des exemples supplémentaires de données pour tous les énoncés de problèmes sont présentés aux adresses suivantes :
-
Portail canadien des données ouvertes (en anglais et français) : ensemble de données contenant les métadonnées principales des ensembles de données disponibles sur le portail des données ouvertes du gouvernement du Canada.
-
la plateforme AI on Demand (IA sur demande) de l'UE (en anglais uniquement).
-
le site Web sur les données ouvertes (gouvernement de la France) (en français uniquement).
-
Portail central allemand GovData pour les données ouvertes (en allemand uniquement) : vaste catalogue de jeux de données publiques provenant des autorités fédérales, régionales et municipales, permet le téléchargement en masse et les API.
-
Une sélection de références à des ensembles de données utiles du Royaume-Uni (en anglais uniquement)
-
Registre allemand de l’IA (en allemand uniquement) : registre avec une liste des systèmes d'IA utilisés par les autorités allemandes.
-
Developers Italia : Point de référence pour le code et les API utilisés par les services publics italiens (en italien et en anglais).
-
Portail de données e-Gov du Japon (en anglais uniquement) : donne accès aux données ouvertes du gouvernement du Japon.
2. La fonction publique gère un grand nombre de lois, de politiques et de règlements qui sont difficiles à comprendre par la clientèle et les fonctionnaires.
Exemple
Un outil de prévision permettant de recenser les lois et les règlements pertinents qui ont une incidence sur la mise en œuvre d’un programme ou d’un service.
Exemples de données
- Lois et règlements fédéraux (en anglais et français) : site Web de la législation (Justice) qui offre une version officielle, codifiée et à jour des lois et règlements fédéraux gérés par le ministère de la Justice du gouvernement du Canada. Ces renseignements sont également offerts sous forme de jeu de données XML ouvert (lois et règlements codifiés fédéraux en XML).
- data.gouv.fr (en français uniquement) : données provenant de la direction de l'information légale et administrative en France.
- data.gouv.fr - Legifrance (en français uniquement) : données provenant de Legifrance, le service public pour la diffusion du droit en France.
- France’s Données de la France provenant de la Haute autorité pour la transparence de la vie publique (en français uniquement).
- Législation du Royaume-Uni (RU) (en anglais uniquement) : lois, règlements et modifications, y compris des métadonnées structurées.
- API juridique du Royaume-Uni (en anglais uniquement) : pour agents et chercheurs en IA. Accédez à l'ensemble des données relatives à la législation et à la jurisprudence du Royaume-Uni grâce à la recherche sémantique et à l'intégration du Model Context Protocol.
- Ensemble de données à choix multiples sur les lois et règlements du Japon (en japonais uniquement) : questions à choix multiples dans le domaine juridique, créées et vérifiées à l’aide de plusieurs grands modèles linguistiques.
- Réutiliser le contenu d’EUR-Lex (dans les langues officielles de l'UE) : accès aux lois, à la jurisprudence et à d’autres documents juridiques de l’Union européenne (UE), provenant principalement des institutions européennes. Ces données peuvent être téléchargées gratuitement dans différentes langues à l’aide d’un compte de l’UE.
- Portail de la législation active d’Italie et Journal officiel (en anglais et italien) : Législation (nationale et régionale), règlements, décrets. Ensembles de données juridiques ou avis juridiques.
- Documents imprimés du Bundestag allemand (en allemand uniquement) : archives des transcriptions des séances plénières et des projets de loi en texte intégral, idéales pour la formation aux textes juridiques et réglementaires.
- Journal officiel fédéral allemand (en allemand uniquement) : publication officielle des lois et règlements avec gestion des versions et continuité des archives.
- Documents et publications du Bundestag allemand : documents supplémentaires des comités, protocoles et archives à long terme riches en métadonnées.
- RU serveur MCP du Parlement (en anglais uniquement) : site Web offrant aux responsables de l’IA un accès à des données consultables :
- accès aux publications du Hansard (débats réels, consultables par thème, intervenant et date);
- questions et réponses écrites des parlementaires et consultables à l’aide d’une fonction de recherche sémantique;
- renseignements sur les membres (députés, lords, circonscriptions, relevés de votes et intérêts);
- titulaires de postes au sein du gouvernement et de l’opposition;
- résultats électoraux et données sur les circonscriptions.
Des exemples supplémentaires de données pour tous les énoncés de problèmes sont présentés aux adresses suivantes :
-
Portail canadien des données ouvertes (en anglais et français) : ensemble de données contenant les métadonnées principales des ensembles de données disponibles sur le portail des données ouvertes du gouvernement du Canada.
-
la plateforme AI on Demand (IA sur demande) de l'UE (en anglais uniquement).
-
le site Web sur les données ouvertes (gouvernement de la France) (en français uniquement).
-
Portail central allemand GovData pour les données ouvertes (en allemand uniquement) : vaste catalogue de jeux de données publiques provenant des autorités fédérales, régionales et municipales, permet le téléchargement en masse et les API.
-
Une sélection de références à des ensembles de données utiles du Royaume-Uni (en anglais uniquement)
-
Registre allemand de l’IA (en allemand uniquement) : registre avec une liste des systèmes d'IA utilisés par les autorités allemandes.
-
Developers Italia : Point de référence pour le code et les API utilisés par les services publics italiens (en italien et en anglais).
-
Portail de données e-Gov du Japon (en anglais uniquement) : donne accès aux données ouvertes du gouvernement du Japon.
3. Les administrations publiques comptent un grand nombre de processus souvent complexes, ce qui peut compliquer la prévision des besoins futurs avec exactitude et l’affectation efficace des ressources.
Exemples
- Un outil permettant de prévoir la détérioration des infrastructures, la croissance démographique et les conséquences environnementales afin d’allouer efficacement les fonds limités en fonction des priorités.
- Un outil exploitant des ensembles de données ouvertes, notamment ceux provenant des administrations fédérales, provinciales, étatiques, municipales et commerciales, ainsi que des données en temps réel, telles que la météo, le trafic, les frais d’expédition et les données sur la planification, afin d’accroitre la capacité d’adaptation, la souplesse et l’efficacité des mesures d’intervention en cas de catastrophe et la résilience de la chaîne d’approvisionnement en situation d’urgence.
Exemples de données
- Données du Recensement de la population du Canada (en anglais et français) : données détaillées du Recensement et outils de référence de Statistique Canada, ce qui comprend la géographie du recensement.
- Base de données ouvertes sur les infrastructures (en anglais et français) : ensemble de données ouvertes concernant entre autres le type et l’emplacement de certaines infrastructures au Canada.
- Produits de données sur le climat (en anglais et français) : quatre ensembles de données concernant le Canada :
- les données d’almanach moyennes et extrêmes;
- les sommaires climatologiques mensuels;
- les normales climatiques canadiennes;
- les radars météo historiques au Canada.
-
Diverses données géospatiales sont disponibles à partir des cartes ouvertes accessibles sur le Portail du gouvernement ouvert et Geo.ca. Ce dernier est la source officielle de données géospatiales et comprend des données ouvertes, des applications et des cartes. Des ensembles de données précis ayant trait aux LSR peuvent être consultés les ensembles de données du laboratoire de solutions rapides du G7 (en anglais et français).
-
Nomis (statistiques officielles relatives au recensement et au marché du travail au Royaume-Uni) (en anglais uniquement) : données relatives à la démographie et au marché du travail aux niveaux national, régional et local
-
Planning.data.gov.uk (en anglais uniquement) : données relatives aux aménagements et aux infrastructures au Royaume-Uni.
-
Institut national de la statistique d’Italie (en anglais et italien) : Entrepôt de données et cartes des risques : Données démographiques (population, flux migratoires) ; Données socio-économiques ; Données géospatiales et d’infrastructure (en italien et en anglais).
-
Bases statistiques communale, départementale et régionale de la délinquance enregistrée par la police et la gendarmerie nationales de la France (en français uniquement).
-
Les "ensembles de données de forte valeur” présélectionnées par la France (en français uniquement).
-
Données relatives au Référentiel National des bâtiments (en français uniquement).
-
Service public de la donnée de France (en français uniquement) : comprend neuf ensembles de données, avec des données de référence solides notamment dans les domaines géographique, privé et économique.
-
Portail de produits du DWD (service météorologique allemand) (en allemand uniquement) : accès interactif, aperçus et téléchargements en masse pour les ensembles de données climatiques.
-
Office fédéral allemand de la statistique (en allemand et en anglais) : séries démographiques à long terme sur la population, les naissances, les décès, les migrations et les structures par âge.
-
Portails nationaux et régionaux allemands de données statistiques ouvertes (en allemand uniquement) : API et exportations en masse pour les indicateurs socio-économiques, les infrastructures et les statistiques régionales.
-
Géoportails fédéraux allemands (en allemand uniquement) : géoportails fédéraux et implémentations INSPIRE, ensembles de données géospatiales sur les infrastructures, l'utilisation des terrains, les sols et les zones protégées.
Des exemples supplémentaires de données pour tous les énoncés de problèmes sont présentés aux adresses suivantes :
-
Portail canadien des données ouvertes (en anglais et français) : ensemble de données contenant les métadonnées principales des ensembles de données disponibles sur le portail des données ouvertes du gouvernement du Canada.
-
la plateforme AI on Demand (IA sur demande) de l'UE (en anglais uniquement).
-
le site Web sur les données ouvertes (gouvernement de la France) (en français uniquement).
-
Portail central allemand GovData pour les données ouvertes (en allemand uniquement) : vaste catalogue de jeux de données publiques provenant des autorités fédérales, régionales et municipales, permet le téléchargement en masse et les API.
-
Une sélection de références à des ensembles de données utiles du Royaume-Uni (en anglais uniquement)
-
Registre allemand de l’IA (en allemand uniquement) : registre avec une liste des systèmes d'IA utilisés par les autorités allemandes.
-
Developers Italia : Point de référence pour le code et les API utilisés par les services publics italiens (en italien et en anglais).
-
Portail de données e-Gov du Japon (en anglais uniquement) : donne accès aux données ouvertes du gouvernement du Japon.
4. Les besoins de la clientèle en matière de communication sont très variés et les interactions avec le gouvernement peuvent s’avérer difficiles et frustrantes, exacerbant ainsi les obstacles existants.
Exemple
Un outil permettant :
- de recueillir et de vérifier les renseignements fournis par une personne;
- de demander des renseignements supplémentaires en fonction du programme;
- d’aider les personnes qui l’utilisent à rassembler les renseignements utiles pour remplir des formulaires, rédiger un courriel ou se préparer à une discussion avec une personne du gouvernement ou une personne exerçant des fonctions similaires.
Exemples de données
-
Répertoire de services du GC (en anglais et français) : liste complète des services offerts par le gouvernement du Canada.
-
InfoBase du GC − ensembles des données ouvertes (en anglais et français) : données sur les programmes, les finances, la gestion des personnes et les résultats.
-
Portail du gouvernement ouvert (en anglais et français) : renseignements sur les programmes à différents niveaux du gouvernement du Canada.
-
data.gouv.fr - Legifrance (en français uniquement) : Données provenant de Legifrance, le service public de diffusion du droit en France.
-
Données de la France provenant de la Haute Autorité pour la transparence de la vie publique (en français uniquement).
-
Catalogue des services fédéraux allemands (en allemand uniquement): liste centralisée des services administratifs avec les descriptions des procédures, les documents requis et les formulaires.
-
OffenesDatenPortal.de d’Allemange (en allemand uniquement) : exemples municipaux d'utilisation des offres de services, statistiques d'utilisation et données de formulaires en ligne.
-
Site web italien des données ouvertes (en italien uniquement).
Des exemples supplémentaires de données pour tous les énoncés de problèmes sont présentés aux adresses suivantes :
-
Portail canadien des données ouvertes (en anglais et français) : ensemble de données contenant les métadonnées principales des ensembles de données disponibles sur le portail des données ouvertes du gouvernement du Canada.
-
la plateforme AI on Demand (IA sur demande) de l'UE (en anglais uniquement).
-
le site Web sur les données ouvertes (gouvernement de la France) (en français uniquement).
-
Portail central allemand GovData pour les données ouvertes (en allemand uniquement) : vaste catalogue de jeux de données publiques provenant des autorités fédérales, régionales et municipales, permet le téléchargement en masse et les API.
-
Une sélection de références à des ensembles de données utiles du Royaume-Uni (en anglais uniquement)
-
Registre allemand de l’IA (en allemand uniquement) : registre avec une liste des systèmes d'IA utilisés par les autorités allemandes.
-
Developers Italia : Point de référence pour le code et les API utilisés par les services publics italiens (en italien et en anglais).
-
Portail de données e-Gov du Japon (en anglais uniquement) : donne accès aux données ouvertes du gouvernement du Japon.
Aidez-nous à élaborer des solutions innovantes fondées sur l’IA qui favoriseront la collaboration, amélioreront l’accessibilité, s’adapteront aux besoins du moment et auront une réelle incidence sociale pour le bien public.
À propos des laboratoires de solutions rapides
Les LSR servent de plateforme pour la résolution de façon novatrice de problèmes concrets touchant le secteur public grâce à l’élaboration de solutions pratiques et évolutives fondées sur l’IA qui peuvent être adoptées par les différents ordres de gouvernement. Cette initiative encourage les participants des pays du G7 et de l’UE à envisager des applications innovantes de l’IA au sein du secteur public tout en accordant la priorité aux principes pour l’utilisation responsable d’une IA, tels que la confidentialité, la sécurité, l’équité, le bien-être social, l’accessibilité et l’explicabilité.
Objectifs
Les LSR visent l’élaboration de solutions innovantes et évolutives aux obstacles liés à l’adoption de l’IA au sein du secteur public. Plus précisément, ce défi a pour objectifs de :
- concevoir des solutions innovantes fondées sur l’IA pour la résolution de problèmes concrets;
- soutenir l’innovation dans le respect des cadres publics existants, tout en garantissant l’interopérabilité et l’évolutivité
- favoriser l’adoption d’approches de conception qui soient centrées sur l’humain, accessibles et adaptées à des besoins divers
Personnes admissibles
Les résidents autorisés de tous les pays du G7 (Canada, France, Allemagne, Italie, Japon, Royaume-Uni et États-Unis) et de l’Union européenne peuvent participer aux LSR.
Les personnes admissibles peuvent être membres :
- de communautés autochtones;
- d’organismes sans but lucratif;
- d’organisations non gouvernementales;
- d’universités et de collèges;
- de coopératives;
- de gouvernements provinciaux, territoriaux et municipaux;
- d’organismes;
- d’organisations internationales.
Remarque : Si vous souhaitez vous inscrire dans la catégorie des 13 à 17 ans ou des 18 à 29 ans, vous devrez peut-être fournir une preuve d’âge afin d’être admissible au financement. Les fonctionnaires qui travaillent pour le gouvernement du Canada peuvent participer, mais ne sont pas admissibles au financement. Vous trouverez tous les renseignements sur l’admissibilité dans le Guide de participation.
Processus et financement
Pour participer aux LSR, les personnes intéressées doivent remplir et soumettre le formulaire de participation accessible à partir du portail Web d’Impact Canada avant le 1er décembre 2025 à 15 h (heure de l’Est). Les soumissions doivent être faites en anglais ou en français. Les dossiers de participation incomplets ou soumis en retard ne seront pas pris en considération.
Les dossiers de participation doivent comprendre :
- les renseignements généraux sur la personne candidate;
- ne description de la solution fondée sur l’IA proposée;
- un court formulaire de déclaration confirmant l’admissibilité;
- l’URL d’une vidéo de présentation de la solution.
De plus amples détails sur le formulaire de participation et les exigences requises sont fournis dans le Guide de participation.
Les dossiers de participation admissibles seront soumis à un processus d’évaluation rigoureux, comprenant les étapes suivantes :
- la présélection qui vise à garantir que les solutions proposées tiennent compte des préjudices et de la protection des données et répondent aux normes minimales de qualité;
- la sélection finale au cours de laquelle un jury interdisciplinaire composé de spécialistes en IA évaluera les solutions proposées selon les critères suivants :
-
Bien commun et incidence : dans quelle mesure la solution est-elle susceptible de générer des avantages concrets pour d'utilisateurs, la clientèle et la société, et dans quelle mesure intègre-t-elle les principes l’utilisation responsable d’une IA?
-
Interopérabilité : dans quelle mesure la solution peut-elle être utilisée et mise en œuvre par différentes administrations ou différents ministères au sein d’une même administration, ou ses résultats peuvent-ils être intégrés aux systèmes ou aux processus en place?
-
Explicabilité : dans quelle mesure les résultats ou les décisions peuvent-ils être expliqués?
-
Adaptabilité : dans quelle mesure la solution peut-elle être étendue ou adaptée de sorte qu’elle puisse être utilisée par un nombre croissant d’utilisateurs, de clients et de clientes, de régions ou de cas d’utilisation? Dans quelle mesure de nouvelles fonctionnalités peuvent-elles être ajoutées?
-
Accessibilité : dans quelle mesure la solution est-elle accessible aux personnes en situation de handicap, aux personnes ayant différents niveaux d’alphabétisme ou aux personnes ayant un accès limité à la technologie?
-
Utilisabilité : dans quelle mesure le système est-il utilisable et dans quelle mesure les principes de conception centrée sur l’humain ont-ils été pris en compte?
-
Calendrier
Les bénéficiaires et toutes les autres personnes ayant participé au processus de sélection recevront des renseignements quant à leur résultat dans le cadre des LSR.
-
Le 17 novembre 2025
Début des LSR et de la période d’inscription. Les problèmes à résoudre sont publiés.
-
Le 1er décembre 2025, 15 h (heure de l’Est)
Date limite pour la présentation des dossiers de participation
-
Décembre 2025 à janvier 2026
Tous les dossiers de participation admissibles feront l’objet d’une présélection et d’une sélection finale. Les juges retiendront jusqu’à 20 dossiers de chaque pays du G7 et de l’UE et les personnes qui les ont soumises seront les finalistes.
-
Février 2026
Évaluation des solutions et sélection des bénéficiaires du financement afin de récompenser les solutions exceptionnelles et innovantes aux obstacles à l’adoption de l’IA au sein du secteur public.
Jusqu’à 100 000 $ CAN au total seront remis aux bénéficiaires de sorte qu’ils puissent améliorer leurs propositions et peaufiner leurs présentations.
Le financement sera réparti comme suit :
• jusqu’à 10 000 $ CAN pour la meilleure solution de chacun des pays du G7 et de l’UE;
• jusqu’à 10 000 CAD pour la meilleure soumission dans les catégories d’âge 13 à 17 ans et 18 à 29 ans, provenant de n’importe quel pays éligible
• des mentions honorables sans récompense financière sur notre site Web.Les bénéficiaires participeront à une journée de présentation virtuelle en mars afin de présenter leurs solutions au jury.
Les bénéficiaires et toutes les autres personnes ayant participé au processus de sélection recevront des renseignements quant à leur résultat dans le cadre des LSR.
-
Mars 2026
Journée de présentation
Jury
Le jury des LSR est un groupe interdisciplinaire composé de leaders du monde universitaire et du secteur gouvernemental représentant les pays du G7 et de l’UE.

Sophie Fallaha
Canada
-
Biographie
Sophie Fallaha est directrice générale du Centre d’expertise internationale de Montréal en intelligence artificielle (CEIMIA). Forte de plus de ses 15 ans d’expérience dans le domaine de l’innovation et du développement durable, elle a dirigé des projets liés à l’intelligence artificielle (IA) responsable à forte incidence dans le but de relever des défis sociaux, économiques et environnementaux. Sous sa direction, le CEIMIA se distingue par sa capacité à mettre au point des solutions d’IA permettant de résoudre des problèmes mondiaux, en particulier dans les domaines de la santé, de l’environnement, de la gouvernance et des droits de la personne.
Sophie joue un rôle clé dans le cadre du Partenariat mondial sur l’intelligence artificielle (PMIA), une organisation multilatérale et multipartite rassemblant 44 pays et des experts de renommée mondiale. En s’appuyant sur son expertise, elle veille à la mise en œuvre de stratégies visant à renforcer l’incidence de l’IA et à promouvoir des pratiques responsables à l’échelle mondiale. Avant de se joindre au CEIMIA, elle a occupé le poste de présidente et directrice générale (PDG) au Centre international de référence sur l’analyse du cycle de vie et la transition durable (CIRAIG), où elle a dirigé des projets liés au développement durable et à l’innovation en collaboration avec des chefs de file mondiaux en matière de développement durable.
Adeola D. Olubamiji, Ph. D.
Canada
-
Biographie
Adeola (Addy) Olubamiji, Ph. D, est une pionnière dans le domaine de la transformation numérique et de la fabrication additive, dont la renommée s’étend à l’Amérique du Nord, à l’Afrique et à l’Europe. Elle est entrée dans l’histoire en 2017 en devenant la première personne noire à obtenir un doctorat en génie biomédical à l’Université de Saskatchewan, au Canada.
Après son doctorat, elle a entamé sa carrière au Canada, puis s’est jointe à une entreprise américaine figurant au classement Fortune 500. En quatre ans, elle y est devenue directrice en plus d’agir à titre de pionnière dans le domaine de la fabrication additive industrielle et d’être une conférencière très prisée dans le milieu des technologies mondiales.
Mme Olubamiji occupe le poste de présidente-directrice générale de l’entreprise américaine Pathfinder Consulting, spécialisée dans la migration et l’orientation professionnelle. Elle a créé JobVoy, une plateforme d’orientation professionnelle alimentée par l’intelligence artificielle (IA) dédiée aux professionnels aux États-Unis, au Canada, au Royaume-Uni et en Afrique. Elle est également cofondatrice et vice-présidente de la société Synergy Private Equity Corp, laquelle détient un portefeuille immobilier diversifié comptant plus de 60 investissements aux États-Unis et au Canada.
En tant que fondatrice de la Fondation STEMHub, elle a permis à plus de 15 000 professionnels et jeunes appartenant à des minorités de bénéficier gratuitement de programmes, de formations professionnelles et de mentorat dans le domaine des sciences, de la technologie, de l’ingénierie et des mathématiques (STIM). Son travail dans le domaine de la technologie et de l’incidence sociale lui a valu de nombreuses distinctions. Elle a notamment été nommée parmi les 100 femmes les plus influentes au Canada, et a reçu le prix des 25 grands immigrants du Canada de la RBC et le prix STEP de l’institut américaine de fabrication (American Manufacturing Institute).

Sowmya Vajjala
Canada
-
Biographie
Sowmya Vajjala est agente supérieure de recherches au Conseil national de recherches Canada et se spécialise dans les domaines du traitement du langage naturel et de l’intelligence artificielle (IA).
Sowmya possède 15 ans d’expérience de recherche dans les secteurs universitaire, industriel et public. Elle a travaillé dans les domaines du traitement du langage naturel et de l’IA, et elle possède une expérience particulière des grands modèles linguistiques, de l’évaluation de l’IA, des cas d’utilisation multilingues et des applications destinées aux scénarios à ressources limitées.
Sowmya a été la coauteure d’un ouvrage de renommée internationale intitulé Practical Natural Language Processing, publié par O’Reilly Media en 2020. Elle apporte une perspective multidimensionnelle unique au processus d’évaluation grâce à son expérience de la recherche en IA et du développement d’applications.
Francesca Paola Carli
Union européenne
-
Biographie
Francesca Paola Carli est chargée des projets et des politiques au sein du bureau de l’IA de la Commission européenne, où elle travaille dans le domaine de la recherche et de l’innovation en matière d’intelligence artificielle (IA).
Elle possède plus de 15 ans d’expérience dans la recherche et l’innovation en matière d’IA et d’apprentissage automatique ainsi que les technologies numériques avancées. Son expertise s’étend de la recherche fondamentale en IA à l’innovation fondée sur l’IA.
Francesca est titulaire d’un baccalauréat et d’une maîtrise en génie des télécommunications et d’un doctorat en génie de l’information. Elle a occupé des postes de chercheuse invitée et postdoctorale au département de génie de l’université de Cambridge, au Royaume-Uni, et au département de génie électrique et d’informatique de l’université du Minnesota, aux États-Unis. Elle a reçu le prix d’excellence des actions Marie Skłodowska-Curie de la Commission européenne et a participé à des projets de recherche financés dans le cadre d’importants programmes de recherche publics nationaux et internationaux. Elle a également occupé les fonctions d’évaluatrice pour des programmes de recherche et d’innovation financés par l’Union européenne et d’examinatrice pour des revues scientifiques et des congrès internationaux. Elle contribue au processus d’évaluation en offrant une perspective rigoureuse et interdisciplinaire fondée sur l’excellence scientifique.
Paula Rodriguez Müller
Union européenne
-
Biographie
Paula Rodriguez Müller est chargée de projet scientifique au Centre commun de recherche (CCR) de la Commission européenne et chercheuse à l’université KU Leuven. Son travail consiste principalement à fournir des preuves scientifiques et un soutien politique pour l’adoption et la gouvernance des nouvelles technologies, en particulier celles liées à l’intelligence artificielle (IA), au sein du secteur public.
Elle possède plus de sept ans d’expérience dans la recherche sur le gouvernement numérique, plus particulièrement dans les domaines de l’adoption de l’IA, de l’innovation dans le secteur public, de l’interopérabilité et des interactions entre les citoyens et le gouvernement. Son travail se situe à la croisée de la recherche, de la politique et de la pratique, et soutient les initiatives européennes et internationales en matière d’IA fiable, de services publics numériques et de transformation du secteur public.
Mme Müller est titulaire d’un doctorat en administration publique de l’université KU Leuven et a publié de nombreux articles dans des revues universitaires de premier plan. Alliant une solide expertise méthodologique à une expérience concrète en matière de politique, elle apporte une perspective équilibrée au processus d’évaluation, fondée à la fois sur la recherche scientifique et une expérience concrète en matière de politique.

Raphaël Bévenot
France
-
Biographie
Raphaël Bévenot est gestionnaire de produits d’intelligence artificielle (IA) à la direction interministérielle du numérique, où il concentre ses travaux sur la définition stratégique et la mise en œuvre de stratégies d’IA visant à transformer les administrations publiques.
Il compte dix ans d’expérience dans le domaine de l’ingénierie de données et de la prestation de conseils stratégiques pour l’État, tout particulièrement concernant l’adoption de l’IA générative, les infrastructures souveraines et l’industrialisation des projets d’IA.
M. Bevenot a codirigé la solution « Albert » utilisée par plus de 500 organismes publics et a défini la feuille de route en matière de données pour le ministère de l’intérieur. Il contribue au processus d’évaluation en offrant une perspective étayée par la transformation de demandes stratégiques complexes en solutions techniques évolutives.
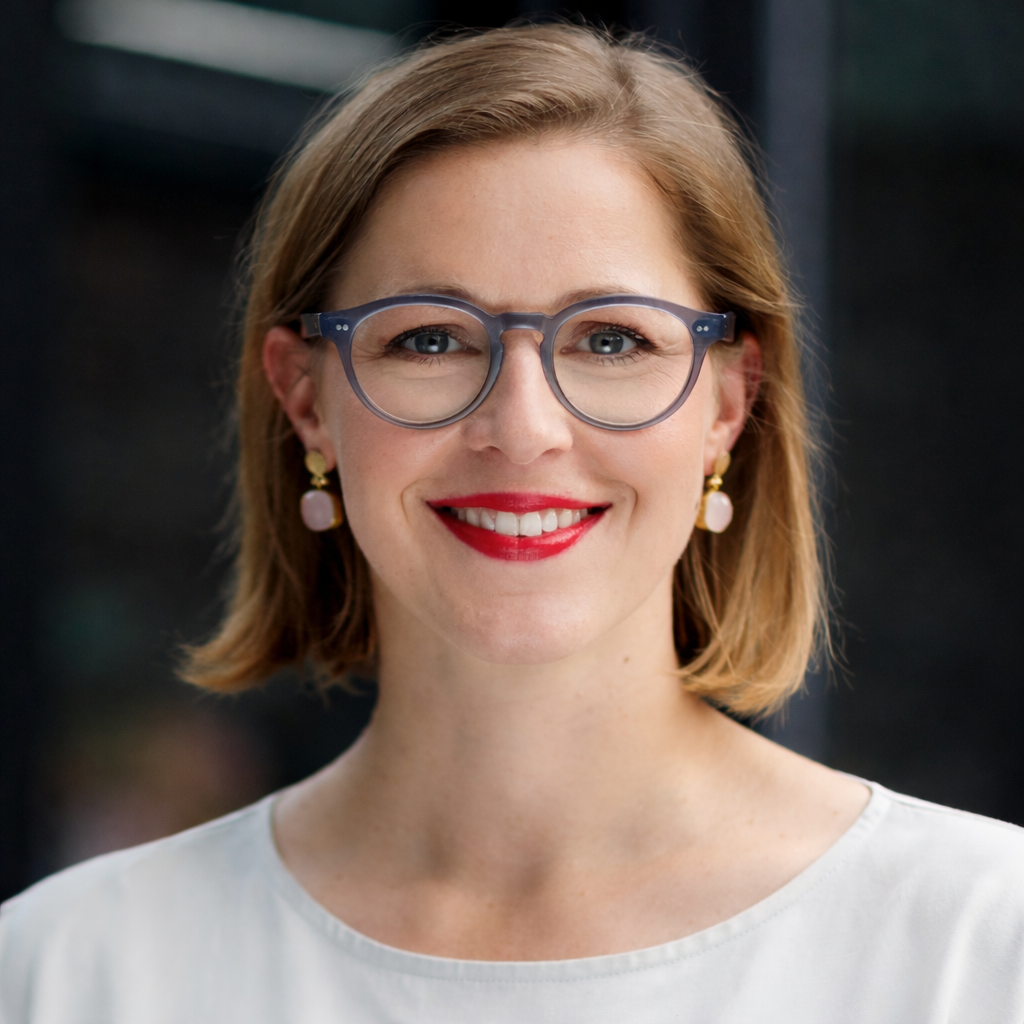
Eliott Dugois
France

Sirko Straube, Ph. D.
Allemagne
-
Biographie
Sirko Straube, Ph. D., est directeur adjoint et gestionnaire administratif de la recherche au centre d’innovation en robotique (Robotics Innovation Center) du centre allemand de recherche sur l’intelligence artificielle (German Research Center for Artificial Intelligence – DFKI), où l’accent est mis sur la recherche et la mise au point de robots autonomes dans divers domaines d’application (en milieu sous-marin, spatial et terrestre).
Il cumule près de 20 ans d’expérience dans les domaines de l’interaction entre les personnes et les machines, des neurosciences et de la robotique, et possède des compétences en intelligence artificielle, en développement durable de logiciels, en interactions intuitives et en transfert d’innovations.
M. Straube est un scientifique principal chevronné et un gestionnaire du développement technologique expérimenté. Il possède une vaste expérience dans l’organisation de projets, les processus d’examen et la réalisation d’évaluations. Tout au long de sa carrière, il s’est efforcé de rassembler divers groupes de parties prenantes et d’informer le public sur les enjeux et les avancées en matière d’intelligence artificielle. Son parcours lui confère une perspective d’ensemble sur le processus d’évaluation, qui tient compte des exigences en matière d’élaboration, de réalisation et d’application et garantit la transparence pour les utilisateurs et l’applicabilité des solutions.
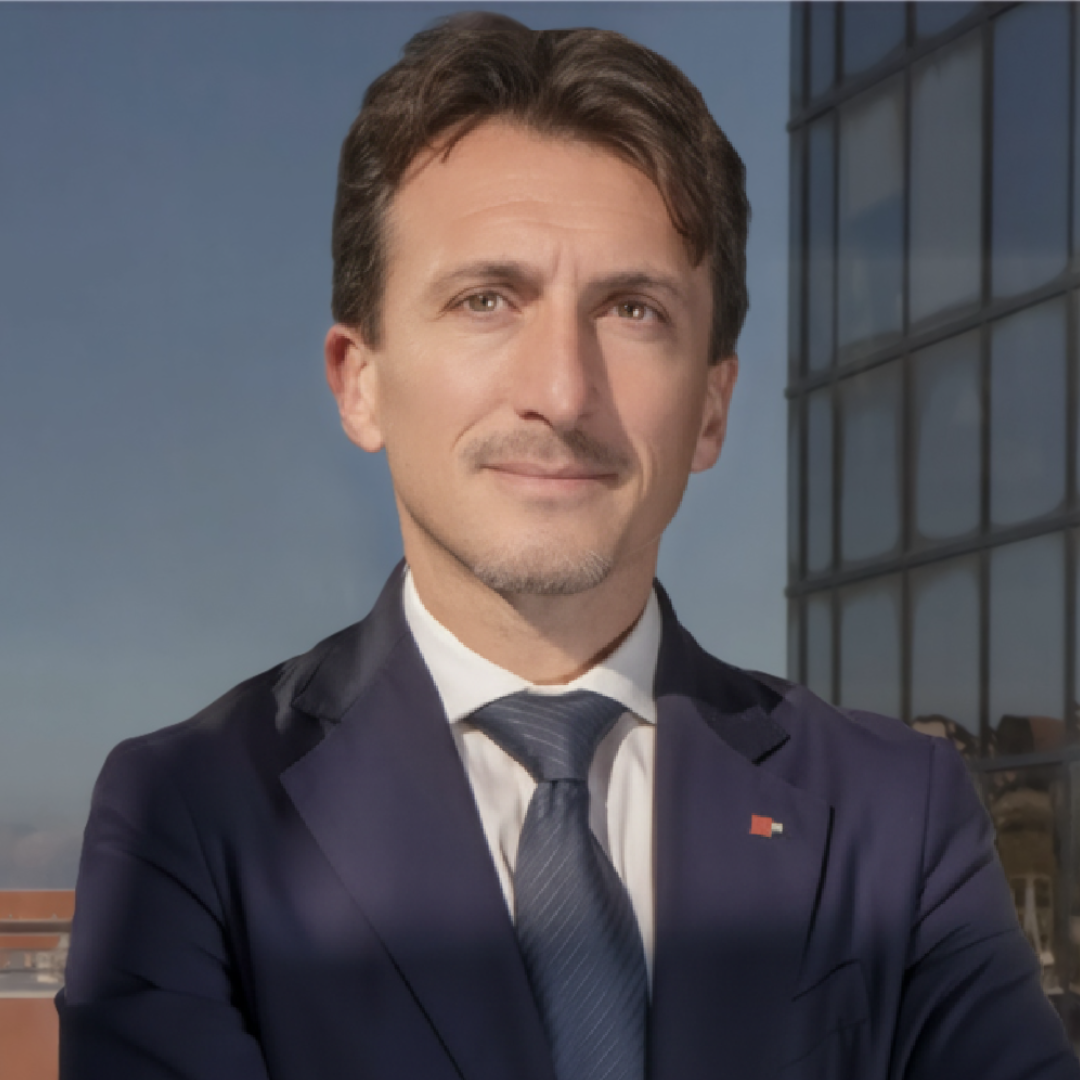
Franziska Weindauer
Allemagne
-
Biographie
Franziska Weindauer est la fondatrice et présidente-directrice générale de TÜV AI.Lab, une coentreprise fondée par certaines des entreprises les plus importantes et les plus influentes du secteur de la certification en Allemagne et ailleurs. À ce titre, elle se concentre sur la promotion d’une intelligence artificielle (IA) fiable grâce à la mise au point de critères de conformité et de méthodes d’essai pour les systèmes d’IA.
Elle met à profit plus de dix ans d’expérience dans le domaine de la politique numérique et des technologies à l’échelle nationale et en Europe, ainsi qu’une expertise particulière en matière de réglementation de l’IA et des données, de création d’entreprises et de leadership.
Auparavant, Mme Weindauer a occupé les fonctions de conseillère principale en matière de politique numérique à la Chancellerie fédérale allemande, de responsable des politiques chez Bitkom et de conseillère auprès d’un député européen influent. Elle contribue au processus d’évaluation en offrant une perspective profondément imprégnée de la politique et axée sur les répercussions.

Roberto Basili
Italie
-
Biographie
Roberto Basili est professeur titulaire à l’université de Rome Tor Vergata (Italie), où il se consacre à la recherche et à l’enseignement dans les domaines de l’intelligence artificielle (IA), de l’apprentissage automatique et du traitement du langage naturel.
M. Basili compte plus de 20 ans d’expérience dans la recherche sur l’adoption des technologies d’IA et le traitement du langage naturel au sein de l’industrie et de l’administration publique. Il possède des connaissances approfondies dans les domaines du traitement de documents, de la gestion de données non structurées, des services intelligents d’extraction d’informations ainsi que la conception, la formation et l’utilisation de grands modèles de langage multilingues.
Roberto Basili a précédemment coordonné le groupe de recherche de Tor Vergata sur l’IA et le traitement du langage naturel. Il a publié plus de 200 articles scientifiques, notamment dans des revues et des travaux liés à des conférences internationales. Il a été nommé président de la section européenne de l’Association of Computational Linguistics (ACL) pour la période allant de 2022 à 2024. En 2012, il a fondé une entreprise innovante en Italie, Reveal s.r. l. Cette dernière propose encore aujourd’hui des produits et des services intelligents sur le marché des technologies de l’information et de la communication. Sa vaste expérience dans le domaine de la recherche et de l’innovation technologique dans l’industrie constitue un atout précieux dans le cadre du processus d’évaluation.
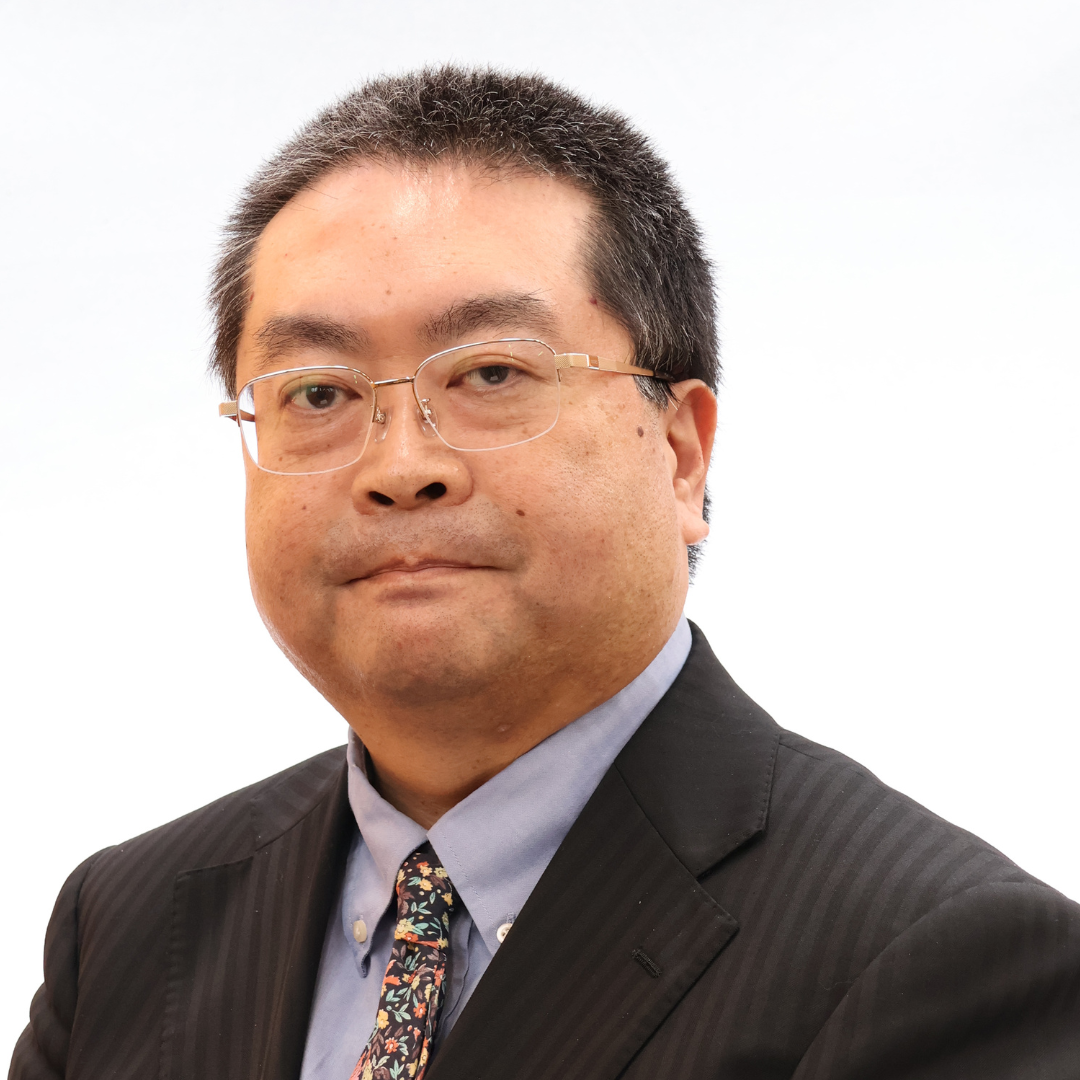
Gianluigi Greco
Italie
-
Biographie
Gianluigi Greco est recteur de l’université de Calabre et professeur titulaire en informatique. Fort de plus de vingt ans d’expérience dans des fonctions de direction dans le milieu universitaire et institutionnel, il est un expert reconnu en matière de stratégies d’intelligence artificielle (IA), de transformation numérique, de politiques d’innovation et d’éthique. Le leadership de M. Greco s’étend à des organisations nationales et professionnelles. Il a été président de l’Association italienne pour l’intelligence artificielle (AIxIA) et est actuellement membre du comité directeur de la société italienne pour l’éthique de l’IA. Depuis octobre 2023, il coordonne notamment le comité du Premier ministre chargé de mettre à jour le plan stratégique national de l’Italie en matière d’IA. Il offre une perspective visionnaire et hautement stratégique au processus d’évaluation.
Shingo Yamaguchi
Japon
-
Biographie
Shingo Yamaguchi est directeur des politiques et des stratégies relatives à l’intelligence artificielle (IA) gouvernementale à l’agence numérique du Japon.
Il a obtenu un diplôme du département d’électronique et de communication de la faculté des sciences et de génie de l’université Waseda en 1995 et s’est joint au ministère des postes et des télécommunications (actuellement le ministère des affaires intérieures et des communications) la même année. Il a terminé ses études à la City University, au Royaume-Uni, en 1999 et est devenu professeur associé à la faculté des sciences de l’environnement et de l’information de l’université Keio en avril 2017, directeur de la division des politiques de communication spatiale au ministère des affaires intérieures et des communications en juillet 2021, directeur de la division des systèmes de technologie des télécommunications en juin 2022 et conseiller au secrétariat chargé de la promotion de la stratégie de développement spatial du cabinet en juillet 2023. Depuis juillet 2025, il occupe le poste de conseiller (stratégie de mise en œuvre de l’IA) à l’agence numérique. Ses domaines d’expertise comprennent les technologies de l’information et de la communication, les systèmes d’information sur la prévention des catastrophes et l’intelligence artificielle. Depuis 2019, il anime chaque année une conférence sur la stratégie en matière d’IA dans le domaine de la sécurité nationale dans le cadre du programme d’études sur la stratégie de sécurité nationale de l’institut national des études sur la défense (National Institute for Defense Studies).
Kyoko Yoshinaga
Japon
-
Biographie
Kyoko Yoshinaga est professeure agrégée chargée des projets à l’école supérieure des médias et de la gouvernance de l’université Keio et chercheuse affiliée à l’institut pour le droit et la politique technologiques de la faculté de droit de Georgetown, où elle concentre ses travaux sur la gouvernance, la politique, le droit et l’éthique des technologies émergentes, en particulier l’intelligence artificielle, selon une perspective internationale et comparative. Elle est également professeure associée invitée à l’institut national d’informatique (NII) et chercheuse invitée à l’institut pour les initiatives futures (Institute for Future Initiatives) de l’université de Tokyo.
Elle cumule près de vingt ans d’expérience en tant que chercheuse pour un groupe de réflexion, où elle a aidé les ministères du gouvernement japonais à élaborer des politiques et des règles en matière de technologies de l’information et de la communication, de médias et de cybersécurité. Elle s’est ensuite occupée de superviser la conformité et la gestion des risques au sein d’une division chargée du développement de l’IA. Cette expérience lui permet d’étayer son travail tant sur la conception de règlements que sur leur mise en œuvre concrète.
Mme Yoshinaga a été la première chercheuse japonaise à être invitée au projet sur la société de l’information (Information Society Project) de la faculté de droit de Yale et contribue à des initiatives nationales et internationales, notamment l’objectif Moonshot 1 de la JST, le comité du ministère japonais de l’Économie, du Commerce et de l’Industrie sur les lignes directrices en matière d’IA pour les entreprises, le comité consultatif sur l’utilisation avancée de l’IA de l’Agence numérique, plusieurs comités d’éthique de l’IA d’entreprises et le Partenariat mondial sur l’IA organisé par l’Organisation de coopération et de développement économique. Elle contribue au processus d’évaluation en offrant une perspective pratique, éclairée par les politiques et orientée vers l’international.

Mallory Durran
Royaume-Uni
-
Biographie
Mallory Durran est directrice de la recherche appliquée et de la technologie à Nesta, l’agence d’innovation britannique pour le bien commun, où elle cherche à exploiter des méthodes et des technologies de recherche avancées au profit du public.
Elle compte plus de 15 ans d’expérience à la jonction des technologies, des politiques et des répercussions sociales, et possède une expertise particulière en matière de gouvernance de l’intelligence artificielle (IA), de prise de décisions fondées sur des données probantes et de transformation numérique dans un contexte gouvernemental. Mallory a été directrice de l’incubateur pour l’IA du gouvernement britannique, rôle dans lequel elle a dirigé les efforts visant à promouvoir le développement responsable de l’IA à l’échelle du secteur public.
Mallory est aussi une entrepreneuse dans l’âme, et s’est taillé une place à partir de l’écosystème des entreprises en démarrage à Waterloo, au Canada. Elle a fait partie de l’équipe fondatrice de Plasticity Labs, une jeune entreprise canadienne ayant fait partie de la première cohorte du programme d’accélération Hyperdrive de Waterloo.
Elle apporte un point de vue unique qui relie la profondeur technique, la mise en œuvre de politiques et l’innovation au sein des entreprises en démarrage au processus d’évaluation, en mettant particulièrement l’accent sur les solutions qui servent un intérêt public mesurable.

Laura Gilbert
Royaume-Uni
-
Biographie
Laura Gilbert, Ph. D. et CBE, est directrice principale de l’intelligence artificielle (IA) à l’institut Tony Blair pour le changement mondial (Tony Blair Institute for Global Change), où elle dirige le nouveau laboratoire d’innovation en IA. Elle crée des applications d’IA propriétaires et ouvertes pour les gouvernements du monde entier dans le but d’améliorer la prise de décision gouvernementale et d’obtenir de meilleurs résultats pour le public.
Elle cumule plus de dix ans d’expérience dans les domaines de la technologie, de la science des données et des politiques publiques, et possède une expertise dans la mise en œuvre de l’IA, la transformation numérique des administrations publiques et la constitution d’équipes techniques à haut rendement dans des environnements institutionnels complexes.
Laura a précédemment occupé le poste de directrice fondatrice de la science des données au 10 Downing Street, où elle a créé l’incubateur gouvernemental pour l’intelligence artificielle (i.AI). Elle a été décorée du titre de commandeure de l’Ordre de l’Empire britannique (CBE) pour ses services rendus dans le domaine de la technologie et de l’analyse en 2024. Elle contribue au processus d’évaluation par son expérience pratique, fondée sur les réalités du déploiement à grande échelle de l’IA au sein du gouvernement.
Elle est titulaire d’un doctorat en physique des particules de l’université d’Oxford et est professeure invitée à la London School of Economics.
Résultats
Le processus d’évaluation du Grand défi IAgouv du G7 est maintenant terminé. Sept bénéficiaires ont été retenus par une série de jurys internationaux. Les bénéficiaires étaient admissibles à un soutien financier d’un montant maximal de 10 000 $ CA pour améliorer leur solution et peaufiner leur présentation pour la journée de présentation. Les juges ont également décerné des mentions honorables et sélectionné des finalistes dont les solutions répondaient aux principaux aspects des critères d’évaluation.
Bénéficiaires
Innervation
Système d’IA multiagents pour la détection des préjugés dans les communications gouvernementales accessibles
Système d’IA multiagents qui détecte et élimine en temps réel les préjugés dans les communications gouvernementales. Actuellement configuré pour les préjugés liés à l’incapacité (capacitisme) à l’aide de guides d’identification des préjugés basés sur les pratiques exemplaires, il peut être facilement étendu à tout type de préjugé grâce à la configuration du guide de style. Il supprime les préjugés des documents, des invites destinés à l’utilisateur et des résultats de l’IA avant leur diffusion, et fournit des explications détaillées pour chaque changement apporté.
Canada | Jameson Jones-Doyle, Tyler Kolody, Jonathan Nuss
Transcription
Présentateurs : Jameson Jones-Doyle, Jonathan Nuss et Tyler Kolody
0:01
[Jameson] Je m'appelle Jameson Jones-Doyle. Je suis le PDG d'Axon Technologies et je suis entrepreneur depuis plus d'une décennie. Je me spécialise dans les technologies avancées qui aident les personnes et les communautés dont ils font partie à obtenir de meilleurs résultats.
0:39
[Jonathan] Bonjour, je m'appelle Jonathan Nuss. Je suis cofondateur d'Axon Technologies, la société à l'origine d'Innervation, et j'ai été impliqué dans les premiers jours en travaillant avec Tyler et Jameson sur la stratégie juridique et d'entreprise derrière cette entreprise. Ce qui m'a le plus enthousiasmé dès le départ, c'est l'accent mis par Innervation sur les systèmes multi-agents et la possibilité d'appliquer cette technologie de manière à rendre les systèmes plus transparents, plus équitables et, en fin de compte, meilleurs pour notre société.
1:07
[Tyler] Bonjour, je m'appelle Tyler Kolody. Je suis l'un des fondateurs et le dirigeant principal de la technologie d'Axon Technologies, les créateurs du cadre Innervation Multiagent que nous présentons ici. Pour le Grand Défi IAgouv, nous nous concentrons sur le problème 4, à savoir que les besoins de la clientèle en matière de communication sont très variés et les interactions avec le gouvernement peuvent s’avérer difficiles et frustrantes, exacerbant ainsi les obstacles existants.
1:41
En tant qu'organisation détenue majoritairement par des personnes handicapées, nous étions très enthousiastes à l'idée de nous y attaquer. Mettre l'accent sur le langage capacitiste et l'élimination des préjugés à l'égard des documents gouvernementaux. Nous espérons qu'il sera plus facile et plus efficace pour les membres du gouvernement de créer du matériel inclusif et de le faire de manière à ce qu'il puisse être validé et qu’il soit transparent afin qu'il puisse être ajusté, corrigé et amélioré au fil du temps sans imposer un fardeau excessif aux membres du gouvernement.
2:14
Donc, pour commencer, nous allons juste faire un petit test ici. À l'heure actuelle, il existe trois configurations différentes, des normes par rapport auxquelles il est mesuré, mais celles-ci peuvent être remplacées par des langages différents, des normes différentes, même en se concentrant sur le racisme par rapport au capacitisme ou à tout autre type de préjugé que vous souhaitez.
2:38
Cela se répartit dans quatre agents différents que nous pouvons voir ici, chacun responsable de l'une des normes ou de l'agent de cadrage, qui n'a pas de norme spécifique, mais qui examine le cadrage de haut niveau et comment les hypothèses que le texte fait à un niveau élevé pourrait être capacitistes. Ceux-ci sont ensuite agrégés dans cet agent, qui comporte également des étapes de validation programmatique qui, bien qu’il ne puisse pas détecter le capacitisme,
3:11
peut valider que le résultat a la structure correcte et a un contenu qui correspond. Ainsi, cela garantit que les données saisies précédemment par ces agents supérieurs sont incluses ou en quelque sorte associées dans le cadre du résultat, ainsi que le résultat présente un format et une structure particuliers qui la rendent facile à analyser et à comprendre.
3:36
Donc, nous pouvons voir que cela fonctionne en ce moment. À l'heure actuelle, il enregistre les pièces jointes des résultats précédents dans le résultat final avant de donner sa réponse définitive dans une minute ou deux.
3:49
Mais chaque étape du processus est entièrement vérifiable, entièrement transparente. Il n'y a pas d'abstraction ou d'obscurcissement, et c'est en quelque sorte au cœur de ce qui rend Innervation unique. Nous croyons fermement que l'IA ne devrait pas aller partout. Il doit aller là où il est censé aller, qu'il a du sens pour vous, et qu'il doit être pour l'autonomisation de l'utilisateur. Même s'il fait une grande partie du travail, même s'il est très automatisé, l'utilisateur et ceux sur lesquels il prend des décisions doivent être d'abord et avant tout dans la conception.
4:24
Donc, nous voyons qu'il s'est terminé ici et qu'il a en fait échoué à l'étape de validation du premier coup. Nous pouvons voir qu'il y a eu un échec de validation, puis qu'il s'est corrigé et a obtenu un succès sur le suivant, ce qui est exactement ce que nous voulons voir.
4:41
Donc, d'un point de vue technique, nous utilisons Django, Docker et Kubernetes pour construire notre système d’arrière-plan et React est notre système d’avant-plan, mais les utilisateurs n'ont pas à le faire, ou les clients n'ont pas à utiliser notre système d’avant-plan. Nous disposons d'une API REST complète et d'une documentation qui est utilisée dans notre propre système d’avant-plan, mais qui est exposée aux clients comme ils le souhaitent. Donc, bien que nous ayons des choses comme le texte volumineux et les modes daltoniens qui sont très agréables et très utiles, si la situation exige qu'ils soient intégrés dans
5:21
une interface existante, c'est tout à fait faisable. Nous rencontrons le client et nous rencontrons l'utilisateur là où il se trouve. Nous ne leur demandons pas de venir à nous.
5:30
Il est donc entièrement interopérable. Vous pouvez aussi, bien sûr, choisir tous les modèles que vous voulez, tous les fournisseurs que vous voulez utiliser ou utiliser des modèles ouverts permettant une sorte de personnalisation complète, ce qui est particulièrement important pour les utilisations axées sur la protection de la vie privée, ce qui n'est pas nécessairement le cas ici, mais le gouvernement doit souvent protéger les données des utilisateurs et nous pouvons en quelque sorte y arriver.
5:57
Nous espérons donc que cela rendra le travail du gouvernement plus efficace dans la mesure où, comme il y a beaucoup de dimensions d'efficacité ou d'efficience en tant qu'institution démocratique, le gouvernement canadien, il est essentiel qu'il soit en mesure d'entendre tous les électeurs. Et il n'y a aucun segment de la population avec qui il est plus difficile de parler, et nous espérons que cela facilitera l'utilisation par défaut d'un langage inclusif et de travailler de manière inclusive. Quant aux prochaines étapes, même si elles semblent un peu utopiques, elles l'étaient aussi il y a trois ans, et nous y sommes aujourd'hui.
6:41
Ce serait un rêve que cela soit réellement utilisé au niveau des députés et de leurs électeurs pour qu'il soit plus facile pour les députés de comprendre ce qui préoccupe leurs communautés dans leur ensemble, quels sont les problèmes et les questions qu'ils ont et qu'ils veulent voir réglés. Ainsi que d'être capable de sortir les détails que les individus ont donnés de leurs problèmes individuels. Évidemment anonymisé, mais pour vous donner le meilleur du haut niveau
7:11
et des échelles individuelles d'une institution démocratique. Donc, pour résumer, nous pouvons voir ici que le résultat est exactement comme nous le voulons. Nous avons le texte original. Nous disposons d'une analyse détaillée et d'une évaluation des risques pour chacun des changements qui ont été apportés. Et enfin, nous avons le contenu réel non-biaisé, qui peut ensuite être servi et utilisé après avoir été vérifié et approuvé par un humain.
7:44
Merci beaucoup de m'avoir écouté et j'espère que vous êtes aussi enthousiastes que nous à l'idée de poursuivre ce partenariat.
Fritz Wolfram Bopp
ResiliAlloc : la plateforme souveraine d’intelligence artificielle pour les infrastructures du G7
ResiliAlloc transforme la maintenance réactive des infrastructures en maintenance proactive. Grâce à l’empilement d’ensembles basés sur la physique et au pseudoétiquetage, notre IA surpasse de 26 % les bases de référence gouvernementales (modèle de Markov). L’approche utilisée combine les données ouvertes avec les mesures « Medical Criticality », « Frost » et « Load-to-Design » pour optimiser les calendriers d’intervention et réduire au minimum le gaspillage budgétaire, tout en donnant la priorité aux biens vitaux dans les pays du G7.
Allemagne | Wolfram Bopp
Transcription
Présentateur : Wolfram Bopp
0:01
[Wolfram] Bonjour à tous, je m’appelle Wolfram Bopp. Le jour, je travaille chez BMW en tant qu’expert en IA. Comme passe-temps
0:09
et pour apprendre, je participe à des marathons de programmation d’IA et à des projets caritatifs. J’aime vraiment me plonger dans des problèmes nouveaux et complexes,
0:17
et c’est vraiment agréable de créer des solutions qui offrent une valeur réelle et mesurable pour le grand public.
0:25
Nous avons choisi de relever le défi,
0:28
de concevoir une solution qui prévoit les besoins futurs et l’allocation des ressources afin de réduire le gaspillage et d’améliorer les services
0:37
en veillant à ce que les ressources soient disponibles là où elles sont nécessaires et quand elles le sont grâce aux données sur les infrastructures.
0:44
Voyons cela de plus près.
0:47
[Narrateur anonyme] Chaque année, les gouvernements dépensent des milliards pour entretenir les routes et les ponts. Et chaque année, des milliards sont gaspillés.
0:57
Nous réparons les infrastructures trop tôt,
1:00
ce qui gaspille de l’argent, ou trop tard, ce qui oblige à effectuer des réparations d’urgence qui coûtent 10 fois plus cher.
1:08
La plupart des gouvernements gèrent des portefeuilles de plusieurs milliards de dollars en utilisant des courbes
1:15
d’amortissement statiques basées sur l’âge qui permettent simplement d’estimer quand un pont risque de s’effondrer. Et si nous pouvions prédire les défaillances structurelles avant que les fissures
1:24
n’apparaissent? Et si nous pouvions optimiser chaque dollar provenant des impôts? Voici ResiliAlloc,
1:32
la première plateforme souveraine d’intelligence artificielle pour les infrastructures du G7.
1:39
ResiliAlloc n’est pas seulement un tableau de bord.
1:43
C’est un moteur physique dynamique. Nous avons rejeté la norme industrielle consistant à utiliser des feuilles de calcul statiques.
1:52
Nous avons plutôt construit une architecture moderne à fonctionnalités d’entrepôts. Notre moteur en essaim ingère des signaux en temps réel provenant de sept API mondiales.
2:05
Nous combinons la base de biens statiques d’Odin avec des contraintes dynamiques. Nous extrayons
2:12
les cycles historiques de gel-dégel d’Open Meteo pour modéliser les chocs thermiques. Nous extrayons
2:20
les modèles de trafic en temps réel direct de TomTom pour mesurer la fatigue structurelle et, surtout,
2:28
nous effectuons des calculs pour les ponts essentiels sur le plan médical qui, s’ils étaient fermés,
2:34
empêcheraient les ambulances d’atteindre un hôpital. Mais c’est là que ResiliAlloc se démarque.
2:42
Nos concurrents vous diront : « nous ne pouvons pas prédire les risques, car les données ouvertes ne comportent pas d’évaluation des conditions ».
2:51
Nous avons prouvé qu’ils avaient tort. Nous avons utilisé une stratégie fédérée de vérification sur le terrain. Nous avons
2:57
entraîné notre IA sur plus de 6 000 documents techniques validés provenant des États-Unis, du Royaume-Uni et du Québec.
3:07
À l’aide d’un ensemble de superposition primé de Kaggle,
3:10
nous avons transféré ce renseignement aux biens locaux.
3:15
Nous avons mis en place un pseudoétiquetage, permettant au modèle d’apprendre par lui-même les nuances de l’environnement local.
3:24
Au final, nous avons devancé le modèle standard du gouvernement de 26 %.
3:31
Nous sommes passés de la devinette à l’ingénierie de précision.
3:37
Jetons un coup d’œil au tableau de bord du contrôle de mission. Le système analyse près de 5 000 biens provinciaux. À l’écran, vous voyez
3:47
une mer de rouge. Notre IA a trouvé 140 biens essentiels qui risquent de connaître une
3:56
défaillance imminente en raison d’une charge de trafic élevée et d’un choc thermique.
4:02
Observez ce qui se passe lorsque nous appliquons un budget d’urgence de 25 millions de dollars. L’IA ne
4:10
choisit pas simplement des ponts au hasard. Elle exécute un algorithme d’optimisation NEPSE afin de sélectionner
4:16
les projets offrant le meilleur retour sur investissement pour la sécurité publique dans les limites du budget. Prenons l’exemple du bien 4594.
4:26
L’IA l’a signalé non seulement parce qu’il s’agit d’un bien vieillissant, mais aussi parce que la combinaison
4:33
de camions lourds et de cycles de gel sévères en fait une bombe à retardement.
4:40
ResiliAlloc veille à ce que nous le réparions aujourd’hui.
Élaboration de politiques de précision.
4:46
C’est la puissance de ResiliAlloc. En un seul clic, le moteur d’optimisation
4:52
a analysé près de 5 000 biens et rejeté 99 % d’entre eux pour trouver
5:00
les projets les plus importants dans un exemple de budget d’urgence de 25 millions de dollars.
5:07
Ces projets ne sont pas le fruit du hasard. Ils représentent l’optimum mathématique, c’est-à-dire la réduction la plus élevée possible des risques pour
5:16
la sécurité publique pour chaque dollar dépensé.
5:22
Nous utilisons 96 % du budget disponible avec une précision chirurgicale. Et contrairement à
5:30
d’autres plateformes, ResiliAlloc n’est pas une boîte noire, car nous utilisons un apprentissage automatique rigoureux basé sur
5:38
une ingénierie explicite des fonctionnalités. Nous pouvons retracer chaque prédiction jusqu’à sa cause première, ce qui signifie
5:47
une transparence totale pour les parties concernées et garantit que chaque dollar dépensé peut être expliqué en totalité.
5:58
Mais le tableau de bord va plus loin. Il met le pouvoir de l’analyse hypothétique directement entre les mains des décideurs.
6:08
Vous pouvez ajuster les seuils de tolérance au risque en temps réel, en visualisant instantanément l’impact des
6:15
changements de normes de sécurité sur le budget.
6:21
ResiliAlloc transforme une physique d’ingénierie complexe en une politique claire et exploitable.
6:30
Qu’il s’agisse de 25 millions ou de 1 milliard de dollars, chaque centime est déployé là où cela compte le plus. C’est ainsi que nous construisons un avenir résilient.
6:44
[Wolfram] Pour répondre à vos autres questions. Nous accueillons favorablement les commentaires constructifs et avons abordé les domaines d’amélioration
6:51
et les prochaines étapes concernant l’explicabilité, tout en définissant clairement les prochaines étapes pour l’évolutivité des données et l’adoption par les utilisateurs.
7:02
En ce qui concerne l’explicabilité, nous avons mis à jour notre code et nos vidéos de démonstration afin que les utilisateurs puissent désormais voir explicitement la cause profonde
7:10
de chaque évaluation des risques. Par exemple, l’impact du gel-dégel est de 61 % et celui du trafic routier de 23 %.
7:19
En ce qui concerne la disponibilité, bien que l’expansion immédiate ait été limitée par la disponibilité publique à court terme de jeux de données plus larges du G7,
7:29
l’architecture de notre plateforme est entièrement prête à intégrer et à valider de nouvelles données propres à chaque pays dès que nous y aurons accès.
7:41
En ce qui concerne l’adoption par les utilisateurs, une intégration importante dans les flux de travail réels des gouvernements nécessite une compréhension approfondie
7:48
des besoins des parties concernées. En raison des délais serrés, nous n’avons pas encore été en mesure de mettre en place ces cycles de rétroaction, mais la prochaine étape du développement consistera à dialoguer directement
7:57
avec les utilisateurs finaux afin de recueillir ces informations essentielles.
8:05
En fin de compte, notre objectif est de faire évoluer ce moteur d’IA afin qu’il s’intègre de manière transparente dans les systèmes des pays du G7, permettant ainsi aux gouvernements
8:14
de construire des infrastructures plus sûres, plus résilientes et financées de manière plus équitable.
CIRSFID-ALMA-AI
Graphique de connaissances sur les délibérations alimenté par l’IA pour l’analyse des politiques démocratiques
Un graphique de connaissances sur les délibérations et un système de récupération augmentée qui analyse plus de 36 000 processus de délibération publique sur plusieurs plateformes au moyen d’une recherche sémantique et d’une modélisation thématique pour aider les décideurs à comprendre les points de vue des citoyens, à cerner les thèmes clés et à s’y retrouver efficacement dans les processus de délibération complexes.
Italie | Simone Vagnoni
Transcription
Présentateur : Simone Vagnoni
0:01
Bonjour à tous. Je m’appelle Simone Vagnoni, je suis chercheur doctorant au centre de recherche alma mater pour l’intelligence artificielle centrée sur l’humain de l’Université de Bologne et au groupe d’ingénierie des ontologies de l’université polytechnique de Madrid. Je tiens à remercier mes superviseurs, Monica Palmirani et Victor Rodriguez Doncel,
0:16
et le G7, en particulier pour m’avoir donné l’occasion de présenter mon travail dans le cadre du Grand défi IAgouv : un graphique de connaissances sur les délibérations qui relie le discours démocratique institutionnel et civique à travers des forums dans le temps et l’espace, à l’aide de différents outils d’IA.
0:34
Nous voulions nous attaquer au premier énoncé de problème : la gestion de grands volumes d’informations, à partir de la fracture démocratique liée aux données.
0:46
Le problème vient du fait que les citoyens débattent de la politique climatique sur les médias sociaux et les parlementaires abordent le même sujet en séance officielle, faisant ainsi en sorte que ces conversations restent des îlots isolés de démocratie.
1:01
Il y a donc une grande quantité de données, notamment de données de délibération, provenant des portails officiels, des forums en ligne ou des plateformes participatives comme Decidim, Polis, etc., mais il n’y a aucun moyen de les analyser sur l’ensemble des plateformes.
1:21
Il s’agit là d’une occasion manquée pour faire avancer la démocratie. À l’heure actuelle, les citoyens et les institutions fonctionnent en vase clos.
1:31
Nous avons donc créé le graphique de connaissances sur les délibérations, un cadre unifié qui relie les arguments entre les plateformes, les participants entre les contextes, les sujets entre les institutions et les preuves entre les sources,
1:45
ainsi qu’une interface pour montrer le potentiel de cet exercice.
1:53
Nous avons basé le graphique de connaissances sur une ontologie des délibérations divisée en trois modèles. Le modèle de processus, c’est-à-dire le déroulement des délibérations, les étapes, les calendriers, les organisations, et ce, de l’établissement de l’ordre du jour à la prise de décision. Le modèle de participation, c’est-à-dire qui participe, les citoyens, les experts, les parlementaires, les organisations, et les rôles et relations dans les différents contextes. Le modèle de l’argumentation : qu’est-ce qui est dit? Les arguments, les positions, les preuves,
2:24
les relations de soutien/d’attaque, qui nous aident à approfondir le niveau d’analyse en utilisant le traitement du langage naturel a posteriori.
2:35
Cette façon de faire peut aider à cartographier les arguments et à cerner les politiques afin de mesurer la qualité du discours et la relation entre les différents nœuds du réseau et la modélisation des thèmes, etc.
2:54
Ainsi, à partir de différentes sources de données, nous extrayons les données brutes, en les récoltant à partir du moissonnage Web aux connecteurs API, nous les connectons à l’ontologie et, à partir de là, à des services comme celui que je vais vous montrer maintenant.
3:13
Vous pouvez voir l’interface pour les citoyens, très simplifiée, qui comporte un moteur sémantique où vous pouvez rechercher n’importe quel sujet que vous voulez comparer aux différents
3:25
plateformes et forums que vous avez ici, par exemple la plateforme de consultation Donnez votre avis de l’Europe, du Parlement européen lui-même, la plateforme Polis et celle de Decidim. Par conséquent, si vous recherchez par exemple le mot « vote »,
3:41
grâce à notre recherche sémantique, qui intègre toutes les plateformes et tous les processus participatifs dans un espace d’intégration à l’aide de Sentence-BERT, nous pouvons rechercher chaque mot, non pas par mots-clés, mais par sémantique, en plus de pouvoir trier dans tous les cas, de n’importe quelle manière.
4:18
Nous avons ici le score de similarité sémantique, le nombre de contributions, etc. Voici, par exemple, la réforme électorale canadienne.
4:29
Chaque nœud ici est une contribution qui est connectée à tous les autres nœuds et qui possède ses propres métadonnées : le texte, la date,
4:43
le nom de l’auteur qui, dans ce cas-ci, est anonymisé et le nombre d’approbations et de désapprobations, qui est propre à cette plateforme. Nous pouvons voir ici une représentation visuelle du graphique de connaissances, et nous avons également ici une modélisation des thèmes.
5:03
Puisque nous avons cartographié la sémantique des discussions, nous pouvons cartographier sur toutes les plateformes les sujets qui font l’objet du plus grand nombre de contributions et de discussions. Vous pouvez voir ici quelques exemples.
5:23
Dans la prochaine version, nous allons mettre en place une cartographie des arguments afin d’améliorer la recherche sur la qualité du discours. Pour en revenir à la présentation, il existe de très nombreuses plateformes différentes et nous voulons établir un lien entre elles
5:48
et à travers les institutions afin de mettre en correspondance les attentes des citoyens et les mesures qui seront effectivement prises.
6:01
Les applications dans le monde réel sont le suivi des arguments sur plusieurs plateformes, la surveillance démocratique de la santé, l’évaluation de la qualité des arguments
6:12
et la réduction du fossé civique institutionnel. Il s’agit là, à mon avis, du principal problème de la démocratie aujourd’hui.
6:24
Nous reconnaissons aussi qu’il existe certains défis. Bien sûr, les arguments existent dans leur contexte et pas seulement dans leur structure. Les extraire de leur contexte pourrait donc conduire à des interprétations erronées. Il existe des problèmes liés à la protection de la vie privée et à l’intégrité contextuelle,
6:44
mais comme les données ont été recueillies de manière légale et lisible,
6:57
le lien entre les différentes plateformes soulève de nouvelles préoccupations. Il existe par exemple un risque d’hypersuasion. Plus on dispose de données, plus la manipulation peut être sophistiquée. C’est un problème auquel nous sommes confrontés aujourd’hui, en particulier avec les plateformes privées qui agissent dans leur intérêt personnel et privé, mais
7:20
cela serait également le cas si nous regroupions les données. Notre approche repose sur des limites transparentes et des principes de conception éthique.
7:29
La vision d’ensemble est donc celle d’une démocratie épistémique où les citoyens voient comment leurs voix atteignent les institutions, les chercheurs suivent l’évolution démocratique, les journalistes suivent les chaînes d’argumentation et les parlementaires comprennent l’opinion publique.
7:44
Pour conclure, j’ai un appel à l’action. J’invite les chercheurs à se joindre à nous pour élargir l’ontologie et les sources de données. J’invite les praticiens à mettre en œuvre des normes de délibération dans leurs plateformes. J’invite les citoyens à exiger des processus démocratiques transparents et connectés. Et bien sûr, je vous invite à participer, faites entendre votre voix.
8:05
Merci de votre attention et restez connectés. Voici les codes QR de la plateforme et mon profil LinkedIn. Merci.
Équipe 1902
GovGov : recours aux données gouvernementales pour lutter contre la désinformation
GovGov facilite la lutte contre la désinformation financière en reliant directement les discussions sur les médias sociaux aux données ouvertes officielles du gouvernement. À l’aide de Vertex AI et de RAG, cette solution vérifie instantanément les déclarations relatives aux dépenses publiques, transformant des documents administratifs complexes en réponses accessibles et étayées par des citations afin de restaurer la confiance dans les institutions démocratiques à l’échelle mondiale.
Japon | Satoko Watanabe, Jinnosuke Yamada, Yuzuha Takeuchi, Noyuri Iizuka
Transcription
Présentatrice : Satoko Watanabe
0:00
Bonjour, nous sommes l’Équipe 1902. Aujourd’hui, nous aimerions présenter notre proposition, GovGov - utilisation des données gouvernementales pour lutter contre la désinformation.
0:11
Notre équipe est composée d’étudiants de l’Université Waseda, au Japon. Nous appartenons tous au club de débat de Waseda, et comme nouveau défi, nous avons décidé d’essayer de participer à un marathon de programmation.
0:24
Le défi que nous voulons relever est le problème numéro quatre. Les clients ont une grande variété de besoins en matière de communication, et les interactions avec le gouvernement peuvent être difficiles et frustrantes et exacerber les obstacles existants.
0:39
Dans le paysage numérique d’aujourd’hui, la désinformation est omniprésente. Nous avons cerné un problème très important, à savoir la prolifération de fausses informations non corrigées qui entravent le discours ancré dans les faits. Pour préserver une démocratie saine, nous devons établir deux
0:56
piliers. Un mécanisme de vérification des faits en temps réel sur les médias sociaux et un chemin simplifié vers des données faisant autorité.
1:05
À l’ère de l’IA avancée et de la connectivité omniprésente, les médias sociaux et l’IA générative sont devenus les principales sources d’information. Cependant, ces plateformes présentent des défis structurels importants.
1:20
Par exemple, des rumeurs comme : « qu’allons-nous faire si le problème de l’immigration illégale augmente à cause de l’Agence japonaise de coopération internationale (JICA)? » et « apparemment, il est plus facile pour les étrangers de recevoir des prestations sociales » circulent fréquemment sur X. Les utilisateurs tentent souvent de vérifier ces affirmations en faisant appel à des outils d’IA.
1:41
Facile de les vérifier avec Grok. Pourtant, ces systèmes donnent souvent des résultats inexacts, ce qui conduit à des débats polarisés, improductifs et déconnectés de la réalité.
1:54
De plus, un nombre croissant d’utilisateurs comptent sur l’IA générative comme moteur de recherche principal. Cependant, ces modèles intègrent souvent des sources peu fiables telles que des blogues personnels ou des informations générées par l’IA, compromettant ainsi l’intégrité du discours public.
2:14
Par conséquent, comment rétablir un dialogue constructif? La réponse réside dans la fourniture d’informations hautement fiables.
2:22
Le gouvernement doit jouer un rôle proactif dans les communications directes avec le public. Il s’agit d’un véritable modèle de communication G2C, c’est-à-dire de gouvernement à consommateur. Pour être efficaces, ces informations doivent être à la fois complètes et précises.
2:40
Les fiches d’examen du programme administratif du Japon représentent la seule base de données interministérielle officielle traitant de tous les projets budgétisés.
2:50
Compte tenu de leur nature exhaustive et vérifiée, elles présentent un immense potentiel en tant que plateforme pour lutter contre la désinformation.
2:59
Pour tirer parti de cette ressource, nous avons élaboré deux produits intégrés aux fiches d’examen. GovGov, un prochain robot intégré de nouvelle génération, et GovGovWeb, une interface Web de clavardage basée sur l’IA.
3:14
Tout d’abord, nous présentons GovGov, le robot officiel de vérification des faits du gouvernement. Lorsqu’un utilisateur tombe sur des informations suspectes sur les réseaux sociaux, il lui suffit de les transmettre à GovGov Japon aux fins de
3:26
vérification. Le robot trouve les projets administratifs les plus pertinents à partir des fiches d’examen et en verse les données précises dans un modèle de langage de grande taille (LLM). Ce système de génération améliorée par récupération d’information (GARI) garantit que les résultats sont strictement fondés sur des faits officiels.
3:44
Vient ensuite GovGovWeb. À l’heure actuelle, les citoyens sont confrontés à un dilemme. Les recherches manuelles sur le Web sont encombrantes, et les réponses de l’IA générative ne sont pas fiables.
3:55
GovGovWeb permet de résoudre ce problème en offrant une fonction de suggestion pour les demandes d’informations vagues et en limitant sa base de connaissances exclusivement aux documents gouvernementaux afin d’assurer une fiabilité maximale.
4:08
Veuillez regarder cette démonstration d’une minute. Ici, l’utilisateur pose une question sur les budgets du ministère de l’Économie et du Commerce, et l’IA répond à la question.
4:30
Il s’agit du GovGovWeb et l’utilisateur pose une question sur le budget de l’Agence numérique au Japon.
4:40
Bien que nous ayons lancé GovGov et GovGovWeb comme premières validations de principe, nous croyons que deux autres étapes supplémentaires sont indispensables pour moderniser les communications gouvernementales.
4:51
Il s’agit tout d’abord de l’optimisation du référencement par l’IA et de la mise en œuvre du serveur MCP pour rendre les données gouvernementales lisibles par machine.
4:59
Il est question ensuite de la centralisation des documents publics qui intègre les lois et les procès-verbaux des conseils dans une source unique de vérité pour les réponses des agents conversationnels. Notre vision ultime est celle d’une société où
5:13
les citoyens peuvent collectivement approuver les politiques efficaces et critiquer de manière constructive celles qui nécessitent des améliorations.
5:21
En utilisant les fiches d’examen comme base pour une discussion fondée sur des éléments probants, nous cherchons à favoriser la formation d’un consensus qui transcende les divisions sociales.
5:30
Merci beaucoup d’avoir écouté notre présentation.
Permion, Inc.
DSME™ : Expert en la matière numérique
DSME™ est la première solution permettant d’automatiser l’expertise humaine en la matière pour les tâches d’analyse où l’échec n’est pas une option. DSME™ intègre une programmation logique orientée objet pour l’IA agentique, offrant une architecture neurosymbolique dotée de grands modèles de graphiques et de langage pour fournir une traçabilité probante pour les analyses tout en réduisant la puissance et en augmentant la vitesse et la précision.
États-Unis | Arun Majumdar, Paul Brown, Barry Evans, Paulo Moura
Transcription
Présentateur : Paul Brown
0:00
Nous sommes de Permion et présentons DSME. Arun Majumdar est notre PDG et expert en IA. Paulo Moura est l'auteur de Logtalk, qui fait fonctionner DSME. Barry Evans fait fonctionner l'IA neurosymbolique et je suis Paul Brown, l'architecte en chef.
0:14
La fonction publique doit gérer de grandes quantités d'information, souvent manuellement. Des outils sont nécessaires pour faciliter l'ingestion, l'exploration et la compréhension de documents non structurés. L'expert en la matière numérique de Permion, ou DSME, est une application d'IA multilingue, agentique et fiable pour une évaluation rapide des corpus. En tant qu'analyste des politiques canadiennes, je peux utiliser le DSME pour contribuer à un bac à sable réglementaire de classe mondiale pour renforcer l'intention souveraine, la prudence économique et l'intégrité législative.
0:44
Aujourd'hui, notre corpus contient des documents politiques sur deux thématiques, l'énergie et l'intelligence artificielle. Vers un cadre national de test énergétique de l'IA et des normes minimales de rendement énergétique pour l'IA afin de remplir les mandats de zéro émission nette.
0:59
Avec notre corpus chargé, DSME fournit deux vues qui sont utiles pour trouver des documents susceptibles de vous intéresser. Donc, si, par exemple, je m'intéressais à la politique nationale par rapport à la politique mondiale, je peux trouver les documents qui traitent de ces choses plus fréquemment que les autres.
1:18
Nous avons également un point de vue similaire, mais pour les entités.
1:21
Nous avons donc trouvé ici tous les éléments qui sont fréquemment discutés dans les documents et ce sont vos candidats pour les intervenants.
1:29
Nous pouvons également ajouter toutes celles qui sont liées à un document source unique pour avoir une vue exploratoire des intervenants potentiels à travers tout un corpus de politiques.
1:41
Pour aider un analyste à comprendre les politiques dans de nombreux documents, DSME extraira toutes les phrases impératives déontiques, puis les réduira à un acteur comme « modèles » et « pouvoir », une action comme « exiger » et « traiter », et un objet comme « ordinateurs portables » et « entrées ».
2:02
Pour voir d’où vient l’information, si nous passons la souris sur une action, vous recevrez le papier et la phrase.
2:09
Les actions sont codées par couleur, donc nous avons le rouge pour les obligations, l'orange pour les recommandations et le noir pour les interdictions.
2:18
De plus, des acteurs peuvent être ajoutés et supprimés à volonté pour permettre l'exploration.
2:29
Les politiques peuvent être assez longues à lire, c'est pourquoi le DSME fournit des informations sommatives, y compris des mots clés, des termes clés, qui sont des mots multiples, des entités clés longues, et là vos candidats pour les parties prenantes, ainsi que des résumés. Ainsi, ce premier résumé ici est dérivé d'une analyse structurelle du texte et le deuxième résumé est dérivé de la similitude sémantique avec les mots-clés. Si nous fournissons nos propres mots clés comme « IA », « énergie » et « Canada », nous pouvons créer un résumé sur ce sujet.
3:02
Et c'est créé à l'aide de notre LGM, qui est notre méthode d'extraction de l'information dans son réglage le plus souple de trois. Nous pouvons transmettre cela à un modèle de langage de grande taille (LLM), afin que le LLM puisse le réécrire pour le rendre un peu plus facile à lire, mais cela peut introduire une hallucination. C'est pourquoi nous fournissons cette vue des scores de TRACE, qui montre où le texte de la réponse du LLM à droite chevauche le texte original à gauche. Et vous pouvez également voir la similitude sémantique entre les phrases. Cette phrase ici ne semble pas avoir de chevauchement et pourrait donc être un candidat pour une hallucination.
3:39
Comme pour un résumé, vous pouvez poser des questions directement sur le document. Nous allons donc demander si l'IA peut aider à réduire la consommation d'énergie et nous obtiendrons une réponse. Maintenant, il s'agit d'utiliser notre LGM pour extraire le texte directement du document et vous pouvez retracer ces phrases jusqu'au document pour les voir dans leur contexte en faisant défiler les phrases en surbrillance.
4:01
Et ils sont tous directement tirés du document dans son contexte. Maintenant, si nous présentons le LLM, il y a différents niveaux pour différents niveaux de relâchement et cela vous donnera ces réponses. Et encore une fois, vous pouvez les vérifier pour les hallucinations comme vous pouvez le faire avec les résumés.
4:21
L'élément clé qu'un analyste des politiques aimerait savoir dans tout document particulier est de savoir quelles sont les politiques. Par conséquent, DSME extrait les clauses impératives déontiques et trouve un acteur, une action et un objet. Il vous donnera la modalité ainsi que le texte de la phrase. Il peut dire s'il est nié et s'il y a une condition, et vous pouvez retracer ce texte pour le trouver dans le contexte du document.
4:48
Nous fournissons également ces filtres afin de pouvoir trouver tous les éléments niés pour identifier les interdictions, ou peut-être trouver toutes les obligations associées à une condition.
5:03
Cela permet à un analyste d'explorer rapidement les politiques contenues dans un document.
5:10
Afin d'aider un analyste à comprendre le domaine du discours d'un document particulier, DSME fournit quelques outils qui fournissent des informations structurées. Donc, celui-ci montre à quel point certains termes clés et expressions clés sont fortement liés les uns aux autres et à quoi ils sont liés. L’IA est donc liée à un impact élevé, à la technologie, à l’énergie, à l’utilisation, à l’admissibilité et au Canada.
5:36
Cela montre à quel point les choses sont liées, mais pas comment elles sont liées. La façon dont elles sont liées vient de la proto-ontologie. Nous pouvons donc voir que les contributions du gouvernement canadien ont une partie provinciale et territoriale, et nous pouvons remonter bien sûr jusqu'au texte source pour voir d'où vient cette information. Cela aidera un analyste à explorer le domaine du discours d'une politique particulière.
6:02
DSME fournit une API HTTP qui peut être utilisée pour automatiser les tâches d'intégration du système, ainsi qu'une bibliothèque Python pour interagir avec cette API. Dans cet exemple, nous allons utiliser cette bibliothèque Python pour effectuer un triage automatisé, et nous créons donc un projet temporaire et téléchargeons un corpus d'IA et d'énergie qui contient 90 sources du monde entier. Nous allons filtrer ces sources en fonction d'endroits intéressants et de sujets intéressants en utilisant les mots-clés qui sont cet ensemble sémantique pour réduire cela à 35 sources. Nous allons ensuite trouver l'emplacement de chacune de ces sources,
6:32
supprimer le projet temporaire et en créer un nouveau appelé « North America AI and Energy », en téléchargeant toutes les sources que nous avons trouvées dans le nouveau projet. Maintenant, vous pouvez continuer avec l'API HTTP ou la bibliothèque Python, mais si un analyste souhaite continuer dans l'interface graphique, il trouvera le projet qu'il attend.
6:51
Merci de votre attention. Nous nous réjouissons à l'idée de collaborer davantage avec les entrepreneurs principaux, les institutions et les gouvernements du G7. Le DSME est une application d'IA multilingue, agente et digne de confiance qui est prête à renforcer notre intention souveraine, notre prudence économique et notre intégrité législative. Pour plus de détails, n'hésitez pas à nous contacter à permion.ai.
Équipe Loganberry
L’avenir de la planification des ressources
Une solution basée sur l’IA qui transforme les données administratives et contextuelles courantes des hôpitaux en journaux d’événements anonymisés, utilise l’exploration de processus pour fournir un flux réel de patients et fournit des informations exploitables aux gestionnaires et aux décideurs des hôpitaux, permettant ainsi une allocation des ressources fondée sur des données probantes et une réduction des temps d’attente à l’échelle nationale, indépendamment de la maturité numérique et de la capacité d’analyse.
Royaume-Uni | Zhiqian Huang, Nigel Cullumbine, Tor Gisvold, Ana Ohde
Transcription
Présentateurs : Ana Ohde, Nigel Cullumbine, Tor Gisvold, Zhiqian Huang
0:00
[Ana Ohde] Je m’appelle Ana Ohde et je suis économiste de la santé. Je m’assure que notre solution offre une valeur économique
0:07
mesurable et un impact durable au niveau de la population.
0:13
[Nigel Cullumbine] Je m’appelle Nigel Cullumbine et je suis dirigeant principal des opérations. Fort de plus de 20 ans d’expérience en tant que leader dans le domaine de la santé et des soins, notamment dans des postes de dirigeant principal de l’information et de dirigeant principal des opérations, je suis un spécialiste
0:22
de la transformation des défis opérationnels en solutions numériques pratiques.
0:27
[Tor Gisvold] Bonjour, je suis Tor Gisvold, dirigeant principal de la technologie. Je dirige notre stratégie technologique et ma tâche consiste à
0:34
créer des plateformes sécurisées et évolutives axées sur l’IA et le nuage d’abord.
0:40
[ZhiQian Huang] Je m’appelle ZhiQian Huang, PDG et cofondateur. J’ai une formation en gestion de crise opérationnelle au sein du service national en matière de santé et j’ai été le premier à utiliser
0:48
l’exploration de processus pour mettre en lumière les flux de patients dans les systèmes de santé.
[Texte à l’écran non prononcé]
Ensemble, nous combinons l’expertise opérationnelle, technique et économique pour bâtir une couche d’intelligence opérationnelle qui aide les gouvernements à allouer les ressources plus efficacement.
1:01
[Narrateur anonyme] Le défi du G7 tient compte de la difficulté à laquelle les gouvernements sont confrontés pour prévoir les besoins et allouer efficacement les ressources au sein de
1:09
systèmes complexes. Dans le domaine des soins de santé d’urgence, ce défi est visible tous les jours.
1:18
Les hôpitaux doivent déployer en temps réel un espace limité pour le personnel et de l’équipement. Pourtant, les décisions restent largement réactives, s’appuyant
1:27
souvent sur l’expérience individuelle plutôt que sur de l’intelligence opérationnelle à la demande liée à des résultats mesurables.
1:34
Notre solution vise à résoudre ce problème.
[Texte à l’écran non prononcé]
Exploration de processus/syntagme nominal - Une méthodologie analytique axée sur les données qui est utilisée pour découvrir, surveiller et améliorer les processus opérationnels en extrayant et en analysant les connaissances des journaux d’événements des systèmes informatiques.
1:43
[Narrateur anonyme] Grâce à l’exploration de processus, nous pouvons analyser individuellement chaque flux de patients en quelques secondes. Une tâche difficile à réaliser
1:51
au moyen des analyses traditionnelles. Notre approche exclusive consistant à classer ces flux en itinéraires structurés constitue la base d’une planification intelligente des ressources. À titre d’exemple,
2:01
nous avons aidé un service d’urgence à comprendre que les retards dans le traitement du sang étaient en réalité dus à la disponibilité des porteurs,
2:08
et non à la capacité du laboratoire.
[Texte à l’écran non prononcé]
Comment tous les hôpitaux peuvent-ils accéder à ces informations?
2:18
[Narrateur anonyme] Loganberry, notre agent IA, permet aux équipes opérationnelles d’interroger ces informations en langage naturel. Loganberry
2:27
est adapté à chaque hôpital et à ses utilisateurs. Il est convivial, indépendamment de leur niveau de maturité numérique et de leurs capacités d’analyse.
2:33
Il triangule les données structurées sur les flux, les procédures opérationnelles normalisées des hôpitaux, les directives nationales et
2:42
les informations contextuelles locales sans que les utilisateurs aient à interpréter les tableaux de bord.
2:48
Nous avons également intégré les commentaires du jury en renforçant l’explicabilité et les garde-fous pour une IA responsable. Nous avons également éliminé les barrières linguistiques pour qu’il soit adopté dans le monde entier.
3:05
Les réponses de l’IA sont désormais sensibles au contexte, et l’IA est capable d’exposer clairement son raisonnement. Notre IA est configurée pour répondre
3:12
dans les limites de son champ d’application lorsqu’on lui pose une question qui dépasse ce champ et sa base de connaissances. Elle ne remplace pas le jugement humain. Elle le soutient. Les données issues de l’exploration
3:20
de processus sont fournies sans l’identité des patients, qui est masquée par l’hôpital avant leur traitement. Et notre module d’intelligence
3:28
ne collecte ni ne traite de données permettant d’identifier les patients.
3:33
Nous avons établi un partenariat avec un fournisseur de technologies d’entreprise qui nous donne un contrôle total sur notre pile logicielle et la résidence des données, ce qui nous permet de nous conformer
3:41
à la législation nationale, notamment au Règlement général sur la protection des données (RGPD) et à la loi européenne sur l’IA. Son architecture est sécurisée et native du nuage, et fonctionne actuellement à grande échelle dans un secteur d’activité
3:50
réglementé. Ainsi, nous avons l’assurance que nous pouvons passer d’un seul hôpital à un déploiement national tout en conservant la gouvernance, la sécurité et la conformité.
[Texte à l’écran non prononcé]
Comment l’hôpital peut-il utiliser les informations pour améliorer l’allocation des ressources?
4:08
[Narrateur anonyme] Nous avons développé un prototype d’intelligence opérationnelle en temps réel depuis notre soumission initiale.
4:19
Ce module permet au personnel de consigner les problèmes opérationnels au fur et à mesure qu’ils surviennent avec l’aide de l’IA pour saisir le contexte de manière cohérente
4:27
plutôt que de se fier sur des messages fragmentés ou des transmissions officieuses. Notre solution relie chaque problème à son impact potentiel sur le flux de patients. Ce
4:36
sera la première fois que des connaissances opérationnelles éprouvées sur la gestion quotidienne des hôpitaux seront saisies sous une forme structurée à l’intention des
4:45
équipes de direction. Notre solution fournit des suggestions sur les éléments à prendre en compte avant de mobiliser des ressources supplémentaires, ce qui crée de la visibilité et
4:54
réduit la charge cognitive liée à la gestion des pressions opérationnelles complexes en temps réel.
4:59
L’IA propose un aperçu de la situation des hôpitaux qui peut être remis en question, ce qui permet aux dirigeants de garder le contrôle.
5:16
Il s’agit du prototype d’architecture pour le déploiement en production. Des contrôles d’entreprise et une couche d’intelligence sont ajoutés, notamment l’authentification,
5:24
la gouvernance, les modèles d’exploration de processus,
5:26
l’intégration des connaissances et l’IA explicable. Cette intelligence opérationnelle est conçue pour alimenter la couche d’intelligence Loganberry, renforçant ainsi
5:35
la compréhension grâce au contexte du monde réel. Comme elle fonctionne sur des données opérationnelles horodatées et des modèles de résidence
5:42
de données configurables, elle peut être déployée en toute sécurité dans tous les pays.
5:47
Elle reflétera désormais le fonctionnement réel de chaque hôpital au niveau local.
5:59
[Texte à l’écran non prononcé]
Saisit le contexte opérationnel.
Relie les problèmes à l’impact sur les flux.
Suit l’impact perçu par rapport à l’impact réel.
Réduit la charge cognitive au niveau du conseil d’administration.
Codifie les connaissances opérationnelles tacites.
Merci, Canada!
Thank you, Canada!
ReadyFormAI
ReadyFormAI
ReadyFormAI fournit une interface conviviale permettant aux citoyens malvoyants de remplir leurs formulaires de services gouvernementaux. L’interface peut être entièrement contrôlée par la voix, transformant le remplissage de formulaires en une conversation.
Groupe d’âge des 18 à 29 ans | Akemi Izuko, Youdong Chen, Steven Tang (Canada)
Transcription
Présentateurs : Steven Tang, Akemi Izuko, Oliver Chen et ReadyFormAI (agent IA)
0:01
[Steven] Bonjour à tous. Nous sommes Steven, Akemi et Oliver, une équipe d’étudiants de l’Université de l’Alberta à Edmonton, au Canada.
0:08
Je m’appelle Steven et, dans le cadre de ce projet, j’ai travaillé à l’amélioration de l’expérience utilisateur et à l’ingénierie agentique.
0:16
[Akemi] Je m’appelle Akemi et j’ai concentré mes efforts sur la conception et la planification du projet, tout en veillant à ce que notre projet soit conforme aux normes les plus élevées en matière de protection de la vie privée.
0:23
[Steven] Ce qui nous a vraiment réuni tous les trois pour ce projet, c’est une frustration commune. À mesure que les services gouvernementaux se déplacent en ligne, les citoyens doivent naviguer dans un paysage numérique complexe pour y accéder.
0:31
Bien que la plupart des gens accueillent favorablement ce changement parce qu’il simplifie le processus et permet de remplir les formulaires à la maison, il représente un obstacle important pour les personnes ayant des besoins en matière d’accessibilité. Le monde numérique est intrinsèquement
0:47
visuel, s’appuyant fortement sur les écrans et le texte. Il s’agit d’un problème important. Une étude récente de Statistique Canada a révélé que 75 % des Canadiens de plus de 55 ans ont une mauvaise vue sans correction.
1:01
[Akemi] Exactement. Nous cherchons à résoudre les problèmes d’accessibilité auxquels les gens sont confrontés lorsqu’ils interagissent avec leur gouvernement. Nous avons tous déjà constaté à quel point il est irritant de remplir des formulaires PDF gouvernementaux.
1:09
Les petites cases et les petites polices créent d’énormes frictions. Ce n’est pas nécessairement la faute des concepteurs du forum. Ils doivent simplement regrouper une quantité massive d’informations dans un espace limité, mais cela entrave l’accès aux services publics pour de nombreux citoyens. Il s’agit là d’un problème qui s’aligne directement sur le
1:25
Grand Défi IAgouv du G7.
Le problème du Grand Défi part du principe que les clients ont des besoins de communication très variés et que les interactions avec le gouvernement peuvent être difficiles et frustrantes, exacerbant les obstacles existants. On nous a demandé de concevoir une solution permettant de communiquer avec les gens d’une manière accessible en tenant compte d’un large éventail de langues, de cultures et (ou) de capacités.
1:41
Pour y répondre, nous avons choisi de concentrer nos efforts sur un problème très répandu, celui des déficiences visuelles.
1:49
Il s’agit d’un obstacle majeur, car il est souvent obligatoire de remplir un formulaire PDF pour pouvoir accéder aux services publics. Avec ReadyFormAI, l’interface visuelle disparaît et le formulaire lui-même devient une conversation. Il vous suffit de parler, le système écoute, comprend et répond avec une clarté absolue.
2:05
Il s’agit d’une intégration transparente de la voix et des données, créant une expérience accessible et qui ne nécessite pas d’effort. Voyons cela en action.
[ReadyformAI] Bonjour. Bienvenue sur ReadyFormAI.
Bonjour. Bienvenue sur ReadyFormAI. - français
2:19
Bonjour. Bienvenue sur ReadyFormAI.
Je suis là pour vous aider à remplir votre reçu de grains. Je peux vous assister en français et dans plus de 40 autres langues. Pour commencer, j’aurais besoin de quelques informations sur votre transaction de grains. Pouvez-vous me donner votre nom et votre adresse de producteur?
[Oliver] Oui, je m’appelle Oliver Chen.
[ReadyformAI] Parfait Oliver, j’ai noté votre nom. Quelle est votre adresse complète et quels types de grains livrez-vous aujourd’hui?
2:42
[Oliver] Euh, revenons au anglais.
2:54
[ReadyformAI] D’accord. Je repasse au anglais. Je vois que vous vous appelez Oliver Chen. Quelle est votre adresse complète et quel type de grains livrez-vous aujourd’hui?
3:02
[Oliver] Euh, 123 Farm Lane, et je livre du blé.
3:09
[ReadyformAI] Parfait. J’ai ajouté votre adresse et indiqué que le type de grains est le blé. Euh, quels sont la date et le lieu de livraison? Avez-vous un numéro de référence de contrat?
3:22
[Oliver] Euh, passons à la section du poids.
3:26
[ReadyformAI] Nous sommes dans la section des enregistrements de pesée. J’ai besoin des mesures de poids pour votre livraison de blé. Quels sont le poids brut, le poids du véhicule et le poids à décharger? Tous en tonnes, s’il vous plaît.
[Oliver] Cela devrait être 5, 10 et 20.
3:36
[ReadyformAI] J’ai saisi ces poids, mais je voudrais vérifier. En général, le poids brut devrait être le chiffre le plus élevé, soit le poids total du véhicule plus les grains, et le poids du véhicule devrait être le plus faible, soit le poids du véhicule sans grains. Vous avez mentionné 5,
3:48
10 et 20 tonnes. Pourriez-vous préciser lesquels correspondent à quoi? Est-ce que le poids brut est de 20 tonnes, le poids du véhicule de 5 tonnes et le poids à décharger de 10 tonnes?
[Oliver] Oh, oui. C’est ça.
[ReadyformAI] Parfait. J’ai corrigé les poids.
4:01
Poids brut 20 tonnes, poids du véhicule 5 tonnes et poids à décharger 10 tonnes. Le système a calculé automatiquement votre poids net. Quel est le taux
4:09
d’impuretés? Avez-vous un numéro de billet de pesée?
[Oliver] Pendant que l’utilisateur parle, l’IA navigue dans des tableaux complexes, fait défiler automatiquement le champ exact qu’il remplit et met instantanément à jour le texte. Les utilisateurs peuvent facilement vérifier les informations saisies grâce aux boutons de grande taille, et l’IA relit n’importe quel champ simple à la demande de l’utilisateur.
4:24
Une fois le formulaire rempli, l’utilisateur clique sur le bouton et le formulaire est exporté au format PDF standard, prêt à être envoyé au gouvernement.
4:34
Je vous redonne la parole, Akemi et Steven.
4:37
[Akemi] Comme vous l’avez vu dans la démonstration, ce qui rend ReadyFormAI exceptionnel, c’est notre capacité à traiter des PDF complexes et à offrir une navigation vocale multilingue tout en garantissant une protection totale de la vie privée.
4:45
Les formulaires administratifs contenant de nombreux renseignements personnels identifiables, nous nous sommes appuyés, lors de notre soumission initiale,
4:52
sur des modèles ouverts standard qui n’étaient pas entièrement isolés. Aujourd’hui, notre produit minimum viable fonctionne entièrement sur un système informatique conforme à la norme SOCK 2. Nous utilisons Modal comme validation de principe, démontrant que l’ensemble de ce pipeline peut être déployé facilement et en toute sécurité directement sur les serveurs gouvernementaux.
5:09
D’un point de vue technique, rendre ce système rapide, privé et performant était un défi amusant. Nous avons construit notre pipeline autohébergé à l’aide de Pipecat, un cadre indépendant de fournisseur pour les pipelines de modèles de langage à plusieurs étapes.
5:18
Pour la conversion de la parole en texte, nous avons choisi le mode Parakeet de NVIDIA. Il est incroyablement léger en termes de calcul, présente le taux d’erreur le plus faible parmi les modèles à poids ouverts et comprend 25 langues. Pour la conversion du texte en parole, nous avons utilisé Qwen 3TS, qui prend en charge 10 langues de sortie, y compris toutes les langues officielles du G7.
5:37
[Steven] Imaginez une expérience d’intégration où les barrières linguistiques disparaissent tout simplement. Vous nous avez mis au défi de créer un outil permettant à chacun d’atteindre une population véritablement mondiale, et nous avons pris cela très à cœur. Aujourd’hui, ReadyFormAI offre à vos utilisateurs une expérience sans heurts et profondément humaine.
5:55
Désormais disponible dans toutes les langues officielles du G7 et dans de nombreuses langues de l’Union européenne, cette expérience semble tout droit sortie d’un conte de fées.
6:03
Notre agent vocal accueille chaleureusement l’utilisateur, en passant par toutes les langues du G7. Dès que l’utilisateur répond, il reconnaît instantanément sa langue maternelle et crée une conversation naturelle et fluide.
6:15
Il s’adapte même instantanément si l’utilisateur change de langue au milieu d’une phrase. L’IA suit sans effort, en restant parfaitement synchronisée. Pendant que l’utilisateur profite d’une expérience localisée et sans faille, notre côté serveur effectue discrètement le gros du travail.
6:30
Il traduit et formate instantanément les mots prononcés en champs PDF standardisés. Il s’agit véritablement d’une solution mondiale qui offre une expérience aussi simple qu’entretenir une conversation.
6:42
Pour conclure, nous souhaitons aborder deux questions clés. Akemi, comment notre solution permet-elle au gouvernement de fonctionner plus efficacement?
6:50
[Akemi] En fin de compte, les gouvernements veulent un accès équitable à leurs services. Sans ReadyFormAI, les citoyens malvoyants sont confrontés à un choix injuste.
6:58
Soit ils sacrifient leur indépendance en demandant à un agent des services publics de lire et de remplir un formulaire à leur place, soit ils renoncent tout simplement au service et s’en privent complètement.
7:06
Comme les formulaires PDF sont la porte d’accès à presque tous les services publics, notre solution améliore considérablement l’accès et donne plus d’autonomie aux citoyens, en plus de libérer les travailleurs de soutien des gouvernements. Cela nous amène à la deuxième question. Steven, quelle serait notre solution finale idéale?
7:20
[Steven] Eh bien, même si notre extension Web élimine déjà beaucoup de friction, l’utilisateur doit encore la rechercher intentionnellement.
7:27
Notre prochaine étape idéale serait que les gouvernements adoptent directement ReadyFormAI dans leur infrastructure Web.
7:34
Ainsi, lorsqu’un citoyen clique sur un formulaire PDF sur un site Web gouvernemental, il devrait avoir la possibilité de l’ouvrir directement dans ReadyFormAI.
7:44
De plus, bien que nous utilisions le nuage sécurisé pour notre produit minimum viable afin de garantir une protection absolue de la vie privée, notre code est entièrement ouvert et optimisé pour fonctionner sur de petits serveurs GPU peu coûteux hébergés sur l’infrastructure souveraine du gouvernement.
8:00
[Akemi] Nous pensons que l’IA ne doit pas se limiter à une boîte de clavardage sur une page d’accueil. Elle doit être un outil qui soutient activement les efforts humains. Merci de nous avoir accordé votre temps et nous espérons que le G7 adoptera des solutions telles que ReadyFormAI.
Mentions honorables
AiAware Oversight
L’IA au service de l’audit et de l’évaluation dans le secteur public : fondée sur des données probantes et explicable
Des audits et des évaluations rigoureux nécessitent des éléments probants opportuns. Notre système accélère la planification, l’évaluation des risques et la conception des études en permettant une analyse comparative rapide et la mise en évidence des thèmes récurrents. Les fonctionnaires peuvent désormais tirer parti des connaissances collectives de l’ensemble de la collectivité de la surveillance pour établir des critères défendables et cerner plus rapidement les risques grâce à la vérification humaine.
Canada
AIMS (AI Against Modern Slavery)
AIMS (AI Against Modern Slavery) L’IA aux fins de la lutte contre l’esclavage moderne : renforcer l’application du projet de loi S-211
AIMS est un système d’IA explicable qui aide Sécurité publique Canada à examiner rapidement des milliers d’énoncés sur l’esclavage moderne au titre du projet de loi S-211. S’appuyant sur plus de 5 700 déclarations annotées par des experts et validées à partir de données canadiennes, AIMS prévoit une classification transparente au niveau des peines et une extraction des preuves et une surveillance humaine afin de renforcer l’application de la loi et d’améliorer la responsabilisation en ce qui concerne la chaîne d’approvisionnement.
Canada
Designerscore
PolicyCompass : le moyen le plus simple de comprendre le gouvernement
De nombreux clients ont de la difficulté à s’y retrouver dans les sites Web complexes du gouvernement qui regorgent d’informations. PolicyCompass permet de résoudre ce problème en traduisant des règlements complexes en langage clair, en voies visuelles et en conseils multilingues. Grâce à sa plateforme et à son extension de navigateur, cette solution réduit la confusion, répond à divers besoins de communication et aide les citoyens à comprendre rapidement et clairement les exigences du gouvernement.
Canada
Également finaliste dans la catégorie d’âge des 18 à 29 ans
Bonjour Tsuki
Agent de conformité de l’emballage
S’y retrouver dans la réglementation sur les dispositifs médicaux présente son lot de difficultés. L’Agent de conformité de l’emballage est un outil d’audit basé sur l’IA qui analyse instantanément les emballages par rapport aux lois fédérales et provinciales, y compris le projet de loi 96 du Québec. Il détecte les cas de non-conformité à l’aide de l’IA multimodale, ce qui réduit la charge cognitive des fonctionnaires et garantit que des produits de santé plus sûrs arrivent plus rapidement sur le marché.
Canada
Équipe Helpful Places
Transparence de l’IA pour les citoyens : permettre la mise en œuvre efficace des normes d’explicabilité de l’OCDE
Un outil basé sur l’IA qui convertit des documents gouvernementaux complexes en explications accessibles et multilingues à l’aide d’une norme de source ouverte. Il analyse les documents techniques qui décrivent les systèmes d’IA et génère des explications en langage clair de l’objectif, des risques, des droits et de l’utilisation des données, ce qui permet aux organisations d’offrir facilement une transparence algorithmique accessible à diverses populations.
Canada
MontreAI
Prédiction du risque d’incendie des bâtiments
Ce système basé sur l’intelligence artificielle prédit le risque d’incendie pour chaque bâtiment d’une ville. Il prédit un score de risque pour les 12 mois suivants. Ce score est utilisé par le service d'inspection de la Ville de Montréal pour établir la liste annuelle des visites.
Canada
FloodWaive
DeepWaive : cartographie rapide des inondations
DeepWaive est le premier modèle d’IA fondamental qui fournit en temps réel en quelques secondes des prévisions d’inondations en 2D. Il simule de fortes pluies et des crues fluviales sur de vastes zones. En remplaçant les modèles hydrodynamiques lents, il permet une évaluation immédiate des conséquences et une gestion dynamique des risques pour une intervention efficace en cas de catastrophe.
Allemagne
Portée civique (Civic Reach)
Civic Reach
Portée civique est une plateforme de communication bidirectionnelle qui adapte les messages gouvernementaux aux besoins linguistiques, au niveau d’alphabétisation et à l’accessibilité de chaque citoyen.
Japon
PolicyEngine
PolicyEngine : calculs des prestations expliqués par l’IA pour le gouvernement et les citoyens
PolicyEngine est une plateforme gratuite et ouverte qui permet aux fonctionnaires et aux citoyens de comprendre l’incidence des politiques relatives à l’impôt et aux prestations sur les ménages. Elle compte plus de 100 000 utilisateurs aux États-Unis et au Royaume-Uni. La plateforme calcule le montant des prestations versées dans l’ensemble des programmes fédéraux et provinciaux et utilise l’IA pour expliquer les résultats en langage clair et montrer les seuils et les règles appliqués.
États-Unis
Également finaliste dans la catégorie d’âge des 18 à 29 ans
Assistant commercial canadien (Canada Trade Intelligence Assistant - CTIA)
Canada Trade Intelligence Assistant (CTIA)
Le CTIA utilise l’IA multiagents pour rationaliser le commerce agricole en unifiant les données fragmentées et en comblant les lacunes en matière de communication entre les organisations gouvernementales et les différents commerçants mondiaux. En rendant l’information commerciale accessible à tous, nous éliminons les obstacles coûteux à l’entrée, améliorons les résultats et diversifions avec succès le marché international du Canada.
Groupe d’âge des 18 à 29 ans
Également reconnue comme finaliste pour le Canada
ImmigrateAI Global
Logiciel d’IA pour simplifier les demandes d’immigration complexes
Un logiciel d’IA qui compare le profil et les documents d’un demandeur aux règles d’immigration, cerne les risques et fournit des conseils clairs. Il réduit la charge cognitive des fonctionnaires, accroît l’uniformité et aide les demandeurs à présenter des demandes complètes. Le même moteur peut prendre en charge d’autres programmes gouvernementaux qui reposent sur des règles complexes.
Groupe d’âge des 18 à 29 ans
Finalistes
Udochukwu Kalu Ogbureke
CivicQuery : assistant d’informations civiques alimenté par l’IA
Allemagne
NorthStar
Étoile polaire : moteur de prévision conversationnelle et de géolocalisation
États-Unis
Équipe NVIDIA
Aide à la récupération
États-Unis
Statistiques sur les soumissions
Soumissions reçues : 152
Soumissions admissibles reçues : 125 (Allemagne, 4; Canada, 107; États-Unis, 6; France, 2; Italie, 1; Japon, 2; Royaume-Uni, 3. Catégorie d’âge des 13 à 17 ans*, 2; catégorie d’âge des 18 à 29 ans*, 24)
Soumissions retenues pour le jury : 81 (Allemagne, 4; Canada, 66; États-Unis, 5; France, 1; Italie, 1; Japon, 2; Royaume-Uni, 2. Catégorie d’âge des 13 à 17 ans*, 1; catégorie d’âge des 18 à 29 ans*, 14)
* Les soumissions étaient admissibles pour les catégories d’âge et de pays.
Restez connecté
Guide de participation : consultez ou téléchargez le Guide de participation pour obtenir un aperçu complet des règles, des échéances et des processus.
Formulaire de participation : soumettez votre dossier de participation dès maintenant pour présenter votre solution innovante!
Pour en savoir plus, suivez-nous :
- Impact Canada
- Secrétariat du Conseil du Trésor du Canada
- le Grand Défi IAgouv du G7
- serveur Discord des Laboratoires de solutions rapides
Pour toute question, veuillez envoyer un courriel à notre équipe à : g7aichallenge-defiiag7@tbs-sct.gc.ca
Appliquer
Ressources importantes
- Guide de participation : consultez ou téléchargez le Guide de participation pour obtenir un aperçu complet des règles, des échéances et des processus.
- Formulaire de participation : soumettez votre dossier de participation dès maintenant pour présenter votre solution innovante!
Qui peut participer ?
Vous pouvez participer individuellement ou en équipe d’au plus quatre personnes. Si vous choisissez cette dernière option, votre équipe doit désigner une personne-ressource qui présentera la demande en votre nom. Il convient de préciser que la personne qui soumet la solution doit avoir au moins 18 ans. Si ce n’est pas le cas, elle peut demander à une personne non participante qui est habilitée à la représenter de le faire pour elle. Les soumissions doivent être rédigées en anglais ou en français. Les demandes présentées en double ne seront pas évaluées. Si une équipe est choisie pour obtenir du financement, les fonds seront directement versés à la personne-ressource.
Joignez-vous à nous
- Événement de lancement (17 novembre 2025, de 9 h à 11 h, heure de l’Est) : événement virtuel marquant le lancement des Laboratoires de solutions rapides. (enregistrement d'événement)
- Table ronde de spécialistes (19 novembre 2025, de 11 h à 13 h, heure de l’Est) : Apprenez-en davantage sur les problèmes à résoudre lors d’une discussion virtuelle modérée à laquelle participeront des spécialistes en matière de politiques gouvernementales et d’IA. (enregistrement d'événement)
- Événement « Demandez-moi n’importe quoi » (25 novembre 2025, de 9 h à 10 h 30 heure de l’Est) : séance de questions-réponses modérée où seront abordées les questions les plus fréquemment posées sur le canal Discord connexe et celles soulevées par les personnes participantes. (enregistrement d'événement)
- Journée de présentation Le 16 mars 2026, de 9 h à 11 h (HAE) : Annonces de financement et présentation des propositions (enregistrement d'événement)
Aucune inscription préalable n'est nécessaire. Rejoignez-nous le jour de l'événement en cliquant sur les liens ci-dessus.
Date de modification : 2026-04-15